数据库系统 期末复习笔记
本文档参考上课PPT以及B站视频https://www.bilibili.com/video/BV1HY4y1b72A
第0章 课程概览
| 章节 | 章节名 | 视频章节 | 备注 |
|---|---|---|---|
| 第1章 | 数据库系统概述 | 第1-2讲 | |
| 第2章 | 关系模型 | 第3-5讲 | 关系代数以及关系演算写查询,域关系演算应该不考 |
| 第3章 | 关系数据库语言SQL | 第6-10讲 | SQL语言写查询,会写DML,嵌入式SQL了解概念即可 |
| 第4章 | 数据依赖与关系模式规范化 | 第14-16讲 | 求闭包,求最小覆盖和候选键,判断是第几范式,判断是不是无损连接分解,分解为3NF或者BCNF |
| 第5章 | 数据库设计 | 第11、13讲 | 画ER图并转换为关系模式 |
| 第7章 | 查询处理与查询优化 | 第21讲 | 代数优化(语法树),物理优化,算物理块数 |
| 第8章 | 事务管理 | 第22、23讲 | 并发控制,可串行化判断,两端封锁 |
| 第9章 | 数据库安全性和完整性 | 第8讲 |
本课程围绕数据库系统的核心理论和应用展开,覆盖九大主题:
- 第1章 数据库系统概述:数据库是将相关数据按一定逻辑结构组织、存储在计算机中、可被多用户共享的数据集合。数据库管理系统(DBMS)是用于管理数据库的软件系统。核心概念包括数据独立性(逻辑独立性、物理独立性)、三级模式结构(外模式、模式、内模式)及两级映象。数据管理经历了人工管理、文件系统、数据库系统三个发展阶段。
- 第2章 关系模型:关系即二维表。核心概念包括域、笛卡儿积、元组、属性、超键/候选键/主键/外键。关系运算分为关系代数(并、差、交、笛卡儿积、选择、投影、连接、除)和关系演算(元组演算、域演算)。关系的完整性包括域完整性、实体完整性、参照完整性和用户定义完整性。
- 第3章 关系数据库语言SQL:SQL集DDL、DML、DCL于一体。核心是SELECT查询语句(单表查询、连接查询、嵌套查询、集合查询)。还包括数据定义(CREATE/ALTER/DROP)、数据操纵(INSERT/UPDATE/DELETE)、视图、数据控制和嵌入式SQL。
- 第4章 数据依赖与关系模式规范化:函数依赖(FD)和多值依赖(MVD)是数据依赖的核心。Armstrong公理系统是FD推理的基础。范式等级:1NF→2NF→3NF→BCNF→4NF→5NF,逐步消除部分依赖、传递依赖和多值依赖带来的异常。模式分解需满足无损连接和保持函数依赖。
- 第5章 数据库设计:分为需求分析、概念设计(E-R模型)、逻辑设计(E-R转关系模型)、物理设计(存储结构与存取方法)、数据库实施和运行维护六个阶段。
- 第7章 查询处理与查询优化:查询优化分为代数优化(等价变换,尽早执行选择和投影)和物理优化(选择存取路径,如索引、散列、排序归并等)。
- 第8章 事务管理:事务具有ACID特性(原子性、一致性、隔离性、持续性)。故障分为事务故障(UNDO)、系统故障(UNDO+REDO)、介质故障(重装备份+REDO)。恢复依赖冗余(备份+日志,遵循"先写日志"原则)。并发控制基于锁(S锁/X锁、三级加锁协议、两段锁协议),目标是保证可串行化。
- 第9章 数据库安全性和完整性:完整性约束分为静态/动态 × 列级/元组级/关系级六类,通过CHECK、断言、触发器等方式实现。安全性包括用户标识鉴别、自主存取控制(DAC)、强制存取控制(MAC)、视图机制、审计和数据加密。
第1章 数据库系统概述
1.1 数据管理技术的发展
研究数据库离不开数据管理的概念。数据库是数据管理的产物,而数据管理是数据库的核心任务。伴随计算机硬件和软件的发展,数据管理经历了人工管理、文件系统和数据库系统三个发展阶段。
人工管理阶段
- 背景:没有操作系统,没有数据管理软件,用户用机器指令编码,通过纸带机输入程序和数据,程序运行完毕后,由用户取走纸带和运算结果。
- 特点:
- 数据不保存在计算机内
- 没有专用的软件对数据进行管理
- 只有程序(program)的概念,没有文件(file)的概念,数据的组织方式必须由程序员自行设计与安排
- 数据面向程序,即一组数据对应一个程序
文件系统阶段
- 背景:外部存储器已有磁盘、磁鼓等直接存取存储设备;软件领域出现了高级语言和操作系统。
- 特点:
- 系统提供一定的数据管理功能:存取方法、支持对文件的基本操作、数据的存取基本上以记录为单位
- 数据仍是面向应用的
- 数据与程序有一定的独立性:文件的逻辑结构与存储结构由系统进行转换
- 存在的问题:
- 数据与程序的独立性差
- 数据的共享性差,冗余度大
- 数据的不一致性
- 数据查询困难(记录之间无联系,应用自己编程实现)
- 数据完整性难于保证
数据库系统阶段
从20世纪60年代末开始,数据管理全面进入数据库系统阶段,其标志是三件大事:
- 1968年,美国IBM公司推出层次模型的IMS系统
- 1969年,美国CODASYL组织发布了DBTG报告,提出网状模型
- 1970年,美国IBM公司的E.F.Codd连续发表论文,提出关系模型,奠定了关系数据库的理论基础
数据库系统阶段的特点:
- 数据共享性好、冗余少:数据不再面向某个应用程序,而是面向整个系统。当前所有用户可同时存取数据库中的数据。数据库系统也不仅要描述数据本身,还要描述数据之间的联系。
- 数据结构化:按照一定的数据模型,将各种数据组织到一个结构化的数据库中,数据库中的数据不再是一盘散沙。
- 数据独立性高:
- 数据的逻辑独立性(logical data independence)是指当数据的总体逻辑结构改变时,数据的局部逻辑结构不变,由于应用程序是依据数据的局部逻辑结构编写的,所以不必修改应用程序,这样保证了数据与程序间的逻辑独立性。
- 数据的物理独立性(physical data independence)是指当数据的存储结构改变时,数据的逻辑结构不变,当然更不必修改应用程序。
- 统一的数据控制功能:
- 数据的安全性控制(Security):保护数据以防止不合法的使用所造成的数据泄露和破坏,措施包括用户标识与鉴定、存取控制。
- 数据的完整性控制(Integrity):数据的正确性、有效性、相容性,措施包括完整性约束条件定义和检查。
- 并发控制(Concurrency):对多用户的并发操作加以控制、协调,防止其互相干扰而得到错误的结果并使数据库完整性遭到破坏,措施为封锁。
1.2 数据库系统
数据库系统通常是指数据库和相应的软硬件系统。主要有数据库、数据库管理系统以及各类数据库用户三大部分。
数据库
数据库是一个统一管理的持久存储的数据集合,这些数据应用于某个应用系统中:
- 描述了现实世界的某些方面
- 数据间联系密切,具有最小的冗余度和较高的独立性
- 服务于某个特定的应用
- 可被多用户共享使用
数据库系统用户
- 数据库管理员(DBA):全面负责数据库系统的"管理、维护和正常使用"的人员。
- 终端用户:指最终用户,通过应用系统的用户接口使用数据库。常用的接口方式有浏览器、菜单驱动、表格操作、图形显示、报表书写等。
- 应用程序员:负责设计和编写应用系统的程序模块,并进行调试和安装。
1.3 数据模型与数据模式
数据与信息
- 数据是信息的符号表示或称为载体,信息则是数据的内涵,是对数据语义的解释。
- 对于任何数据而言,都有语法、语义两个方面要引起注意:
- 语法(Syntax)指的是数据的格式规定,如规定数据是数值型、字符型、日期型。
- 语义(Semantic)指的是数据本身的含义。
数据抽象的三个层次
- 现实世界(认识抽象)→ 信息世界(概念模型,如E-R模型)
- 信息世界(转换)→ 机器世界(数据模型,如关系模型、层次模型、网状模型、面向对象模型)
数据模型三要素
数据模型(Data Model)是规定现实世界数据特征的抽象,是用来描述数据的语法、语义和操作的一组概念的集合。数据模型应包含三个要素:
- 数据结构:对实体类型和实体间联系的表达和实现。
- 数据操作:对数据库的检索和更新(包括插入、删除和修改)两类操作。
- 数据完整性约束:给出数据及其联系应具有的制约和依赖规则。
数据模型的三个级别
- 概念数据模型:面向用户、面向现实世界的数据模型,与特定的DBMS无关。
- 逻辑数据模型:用户从数据库系统所看到的数据模型,与DBMS相关。
- 物理数据模型:反映数据存储结构的数据模型。
四种经典逻辑数据模型
| 层次模型 | 网状模型 | 关系模型 | 面向对象模型 | |
|---|---|---|---|---|
| 创始 | 1968年IBM的IMS系统 | 1969年CODASYL的DBTG报告 | 1970年F.Codd提出关系模型 | 20世纪80年代 |
| 数据结构 | 复杂(树结构) | 复杂(有向图结构) | 简单(二维表) | 复杂(嵌套递归) |
| 数据联系 | 通过指针 | 通过指针 | 通过表间的公共属性 | 通过对象标识 |
| 查询语言 | 过程性语言 | 过程性语言 | 非过程性语言 | 面向对象语言 |
| 盛行期 | 20世纪70年代 | 70年代至80年代中期 | 80年代至现在 | 90年代至现在 |
| 各种经典逻辑数据模型之间的根本区别在于数据之间的联系的表示方式不同。 |
- 层次模型的缺点:一是只能表示1:N联系;二是由于层次顺序的严格和复杂,引起数据的查询和更新操作很复杂。
- 网状模型的特点:记录之间联系通过指针实现,M:N联系也容易实现(一个M:N联系可拆成两个1:N联系),查询效率较高。缺点是数据结构和编程都比较复杂。
- 关系模型的主要特征:数据的逻辑结构是"二维表"。与前两种模型相比,数据结构简单,容易为初学者理解。
实体-联系(ER)模型
实体-联系模型用以下三个概念描述现实世界:
- 实体:客观世界中可区别的客观对象或抽象概念。
- 属性:是实体特征的抽象,实体全部属性的集合称为实体型。当实体型全部属性的值确定之后,就得到实体型的一个实例。
- 实体间联系:对应于客观世界中各种对象或抽象概念之间的联系。
模式与实例
- 模式(Schema)是数据库中全体数据的逻辑结构和特征的描述,它仅仅涉及类型的描述,不涉及具体的值。
- 模式的一个具体值称为模式的一个实例(Instance)。
- 型(Type)是指对某一类数据的结构和属性的说明,值(Value)是型的一个具体赋值。
三级模式结构
CODASYL提出模式、外模式、内模式三级模式的概念。三级模式之间有两级映象。
- 模式(Schema):也称逻辑模式,是数据库中全体数据的逻辑结构和特征的描述,是所有用户的公共数据视图,属于逻辑层抽象。一个数据库只有一个模式。定义模式时不仅要定义数据的逻辑结构,而且要定义数据之间的联系,定义与数据有关的安全性、完整性要求。
- 外模式(Sub-Schema):也称子模式或用户模式,属于视图层抽象,是数据库用户能够看见和使用的局部数据的逻辑结构和特征的描述,是与某一应用有关的数据逻辑表示。一个数据库可以有多个外模式。
- 内模式(Storage Schema):也称存储模式,属于物理层抽象。一个数据库只有一个内模式。它是数据物理结构和存储方式的描述,是数据在数据库内部的表示方式。
两级映象
- 外模式/模式映象:定义了该外模式与模式之间的对应关系。当模式改变时,对各个外模式/模式的映象作相应改变,可以使外模式保持不变,应用程序不必修改,保证了数据的逻辑独立性。
- 模式/内模式映象:定义数据逻辑结构与存储结构之间的对应关系。存储结构改变时,修改模式/内模式映象,使模式保持不变,从而应用程序可以保持不变,称为数据的物理独立性。
1.4 数据库管理系统(DBMS)
数据库管理系统(database management system, DBMS)是指数据库系统中对数据进行管理的软件系统,是数据库系统的核心组成部分。DBMS介于用户和操作系统之间,是一种通用的系统软件。
DBMS的主要功能
- 提供各类用户接口(程序员用户、终端用户、数据库管理员)
- 数据库的运行管理(安全性、完整性、并发控制、故障恢复、查询优化)
- 数据目录管理
DBMS体系结构
DBMS作为数据库系统的核心,所有访问数据库的请求都由DBMS来处理。与高级程序设计语言相似,作为数据库语言的一个实现的DBMS也有编译和解释两种实现方法。
- 解释方法:具有灵活、应变性强的特点,能保持较高的数据独立性,对在解释过程中发生的数据结构、存储结构的变化能够适应。但每次执行都要经过所有步骤,开销会很大,效率比较低。
- 预编译方法:在运行以前,对将要执行的数据库语句进行编译处理,保存生成的可执行代码,需要运行时,取出保存的可执行代码加以执行。预编译方法的主要优点在于执行效率高,系统开销小。
多线程DBMS
在单进程多线程结构的DBMS中,系统只创建一个DBMS进程。当有用户申请数据库服务时,DBMS分配至少一个线程为之服务,多个线程并行工作,共享资源。
线程的优点:
- 一个进程可划分为多个线程
- 线程的创建、切换、通信等开销远比进程少
- 线程为进程本身的并发执行提供了手段
数据目录
数据目录(Catalog或Directory)是一组关于数据的数据,也称为元数据(meta-data)。关系数据库中数据目录的组织通常与数据本身的组织相同。数据目录的特点是数据量比较小(与数据本身比)、使用频繁,因为任何数据库操作都要参照数据目录的内容。
第2章 关系模型
2.1 基本概念
关系模型是以集合论中的关系(relation)概念为基础发展起来的数据模型。关系模型理论由IBM公司San Jose研究实验室E.F.Codd率先提出,论文为"A Rational Model of Data for Large Shared Data Banks"。
早期代表系统:System R(由IBM研制)、INGRES(由加州Berkeley分校研制)。
目前主流的关系数据库管理系统软件产品包括:GuassDB, OceanBase, DM(达梦), Kingbase(金仓), IBM DB2 UDB, Oracle, Informix, Sybase, MS SQL Server, MySQL, Access。
域(Domain)
定义2.1:域是一组值的集合,同一个域中的所有值均应具有相同的数据类型。
笛卡儿积
定义2.2:域D1,D2,…,Dn上的笛卡儿积是一个集合:
关系
定义2.3:D1×D2×…×Dn上的任意一个子集均是定义在域D1,D2,…Dn上的一个关系(relation),记为R。
属性
定义2.4:为关系的每个列所起的名字称为关系的属性,一般可表示为A,B,C…。n目关系必有n个属性,表的任意一列对应一个属性,属性的名称称为"属性名",具体元组的属性取值称为"属性值"。
键
定义2.5:
- 超键(super key, SK):如果一个关系中的某个属性或属性集能够唯一的确定一个元组,则称该属性(集)是这个关系上的超键。
- 候选键(candidate key, CK):如果将超键中的任一属性去掉后剩余的属性集不能唯一标识一个元组,则称该属性集是关系上的候选键。
- 主键(primary key, PK):通常从候选键中选择一个使用,这个候选键称为关系的主键。
- 外键(foreign key, FK):如果关系R1中的某个属性集是另外一个关系R2的候选键,那么该属性集对于关系R1而言是它的外键。
关系模式
定义2.6:关系模式(relation schema)是对关系的型的描述,可以表示为:
关系可看作是关系模式在某一时刻的状态或内容,也就是说,关系模式是型,关系是值。关系模式是静态的、稳定的,而关系是动态的、随时间不断变化的。
关系的特征
- 关系中不允许出现相同的元组
- 关系中元组的顺序(即行序)是无关紧要的
- 关系中属性的顺序是无关紧要的
- 同一属性名下的各个属性值必须来自同一个域,是同一类型的数据
- 关系中各个属性必须有不同的名字,不同的属性可来自同一个域
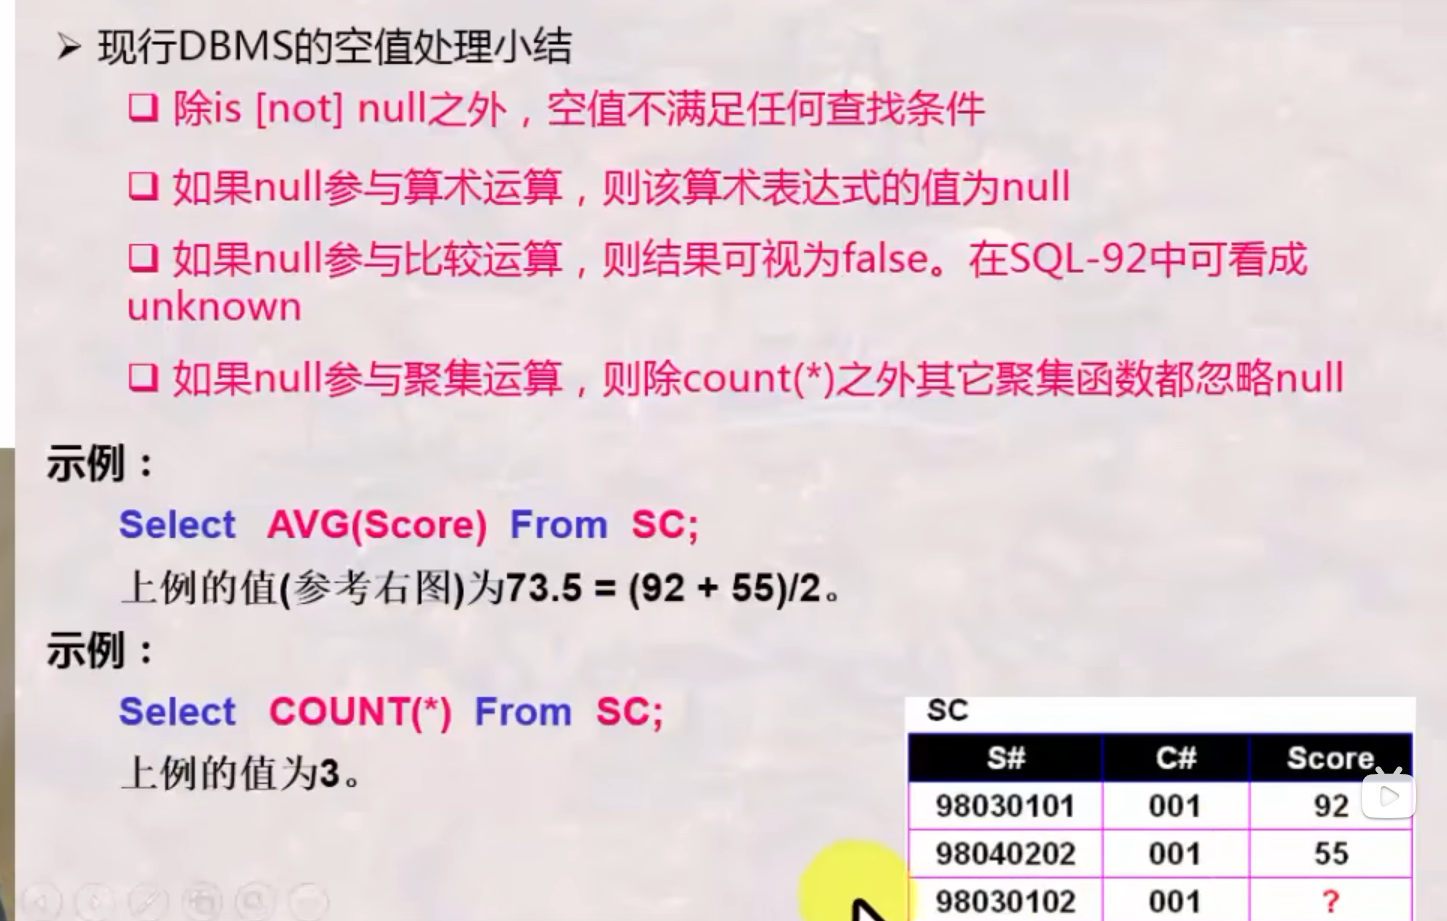
- 关系中每个分量必须是不可分的数据项,或者说所有属性值都是原子的,是一个确定的值,而不是值的集合。属性值可以为空值,表示"未知"或"不可使用"
关系的三种类型
- 基本表:实际存在的表,对应实际存储数据的逻辑表示。
- 查询表:对基表查询得到的结果表。
- 视图表:从基本表或其他视图中导出的表。
关系的完整性
关系模型的完整性(integrity)规则是为了保证数据的正确性和相容性而在关系上施加的约束条件。
- 域完整性约束:元组分量在某个属性上的取值应在其值域之内;元组是否能在某个属性上取空值null,由该属性的语义决定。
- 实体完整性约束:元组在键上的取值不可重复,且不能为null。按照键的定义,如果不同的元组在键上取相同值或空值,则将无法区分两个不同的元组。
- 参照完整性约束:若属性集FK是关系R上的外键,属性集CK是关系S上的候选键,FK引用CK。参照完整性约束要求R上的元组t在FK属性上的取值t[FK]必须是如下两种情况之一:等于关系S中某个元组在候选键CK上的值;取空值null。
- 用户定义的完整性约束:针对某一具体关系数据库的约束条件,反映某一具体应用所涉及的数据必须满足的语义要求。关系模型应提供定义和检验这类完整性的机制。
关系模型的优点
- 提供单一的数据结构形式,具有高度的简明性和精确性
- 逻辑结构和相应的操作完全独立于数据存储方式,具有高度的数据独立性
- 使数据库的研究建立在比较坚实的数学基础上
- 关系数据库语言与一阶谓词逻辑的固有内在联系,为以关系数据库为基础的推理系统和知识库系统的研究提供了方便
2.2 关系代数
关系运算是关系数据库的数学基础,分为关系代数和关系演算两大类。关系代数中运算对象是关系,运算结果也是关系。
运算符包括四类:
- 集合运算符:∪(并),-(差),∩(交),×(广义笛卡尔积)
- 专门的关系运算符:σ(选择),π(投影),⋈(连接),÷(除)
- 算术比较符:>,≥,<,≤,=,≠(< >)
- 逻辑运算符:∧(与), ∨(或), ┐(非)
传统的集合运算
- 并(union):
。满足并运算要求的两个关系是"并兼容"的(R、S都是n元关系且各自的对应属性具有相同的域)。 - 差(difference):
。 - 交(intersection):
。 - 笛卡儿积(Cartesian product):
。m元关系R与n元关系S的笛卡儿积是(m+n)元关系,且每个元组的前m个分量是R的一个元组,后n个分量是S的一个元组。
专门的关系运算
- 选择(selection):
。其中F是选择条件,最简单的选择条件形如 或者 ,X、Y是属性名,c是常量, 是算术比较运算符。 - 投影(projection):
。其中X是关系R的一个属性子集, 表示关系R上的元组t在属性子集X上的分量。 - 连接(join):
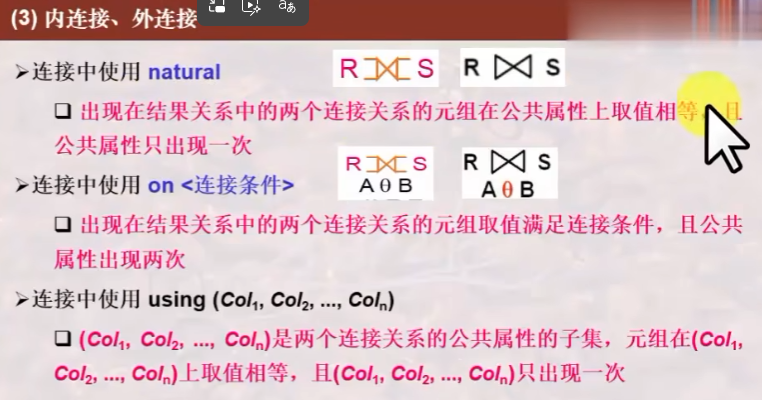
连接: 。 连接是笛卡儿积和选择的复合运算。 - 自然连接:消除了重复属性的等值连接,称为"自然连接"。
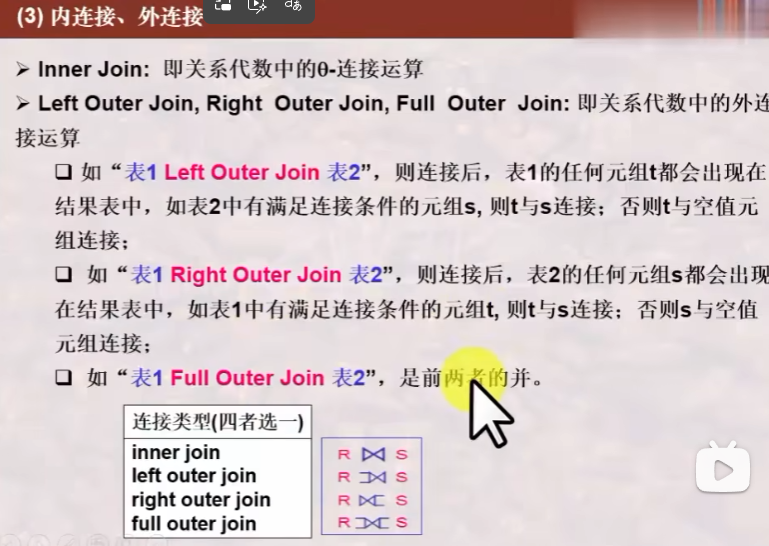
- 外连接:将不满足连接条件的元组仍然保留在结果关系中,并在缺失属性上取null。分为左外连接、右外连接、全外连接。
- 半连接:
,半连接不具有交换率。
- 除(Division):
。
基本运算
并、差、笛卡尔积、选择、投影为五种基本运算。交、连接、除可以用5种基本运算来表达。引进它们不能增强关系代数的表达能力,但可以简化表达。
2.3 关系演算
网课第5讲
关系演算以数理逻辑中的谓词演算为基础,按谓词变元不同进行分类:
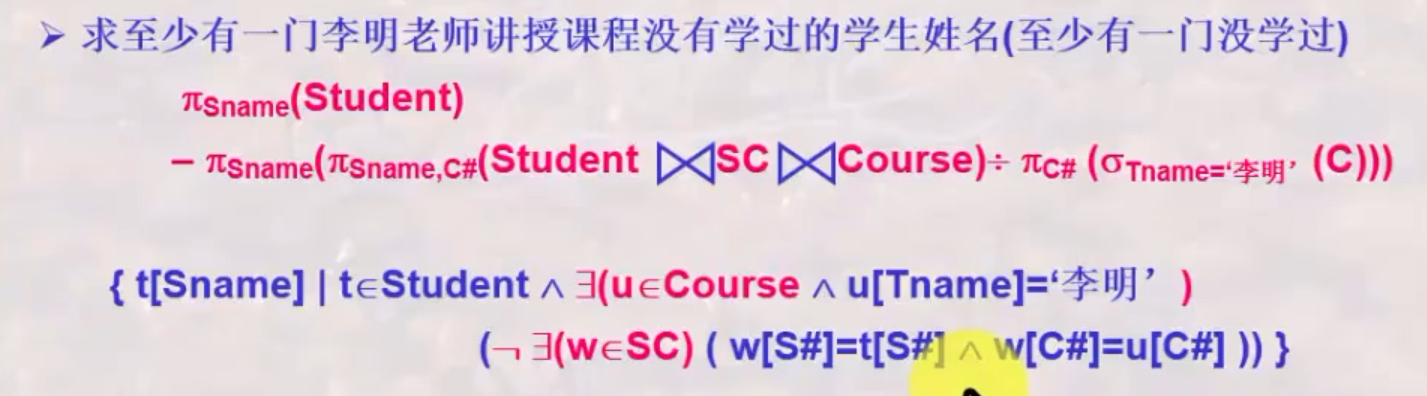
元组关系演算
以元组变量作为谓词变元的基本对象,表达式的一般形式是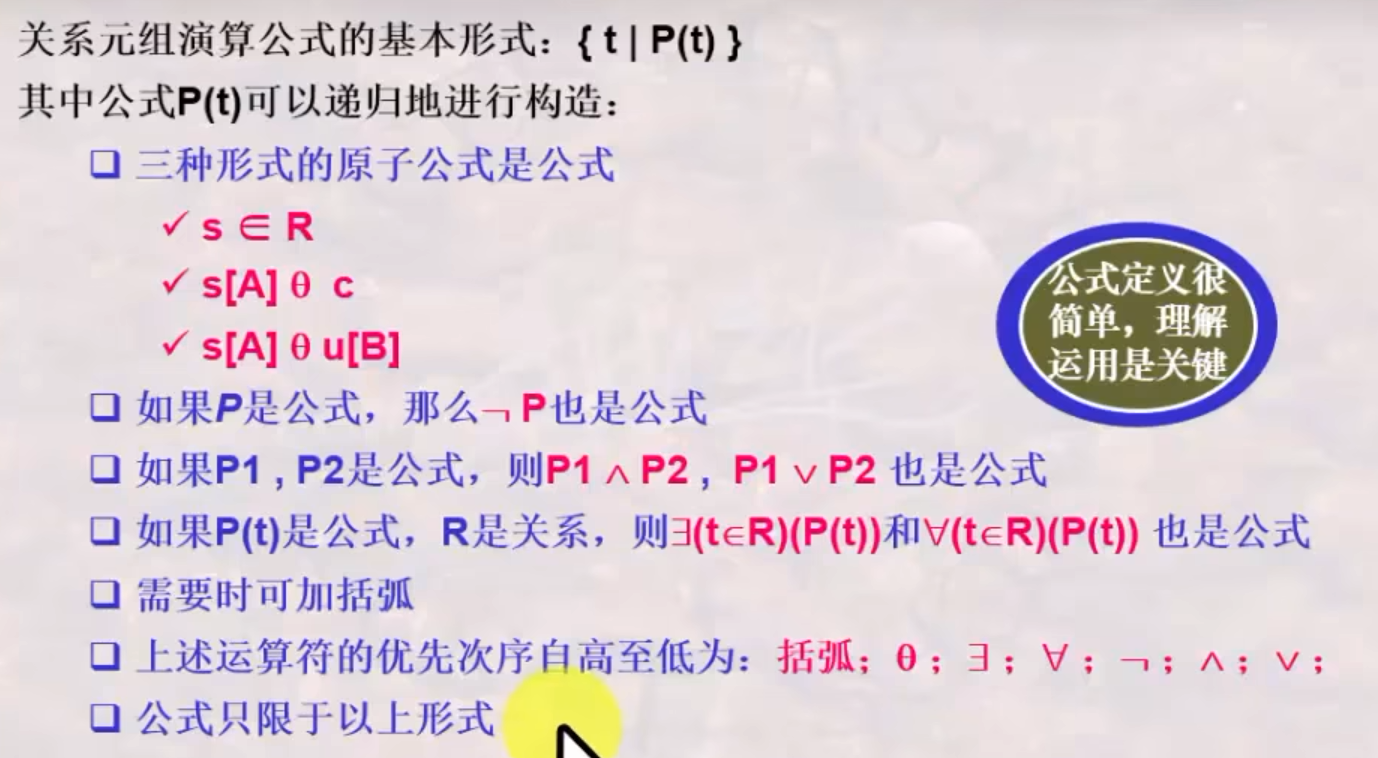
例题:
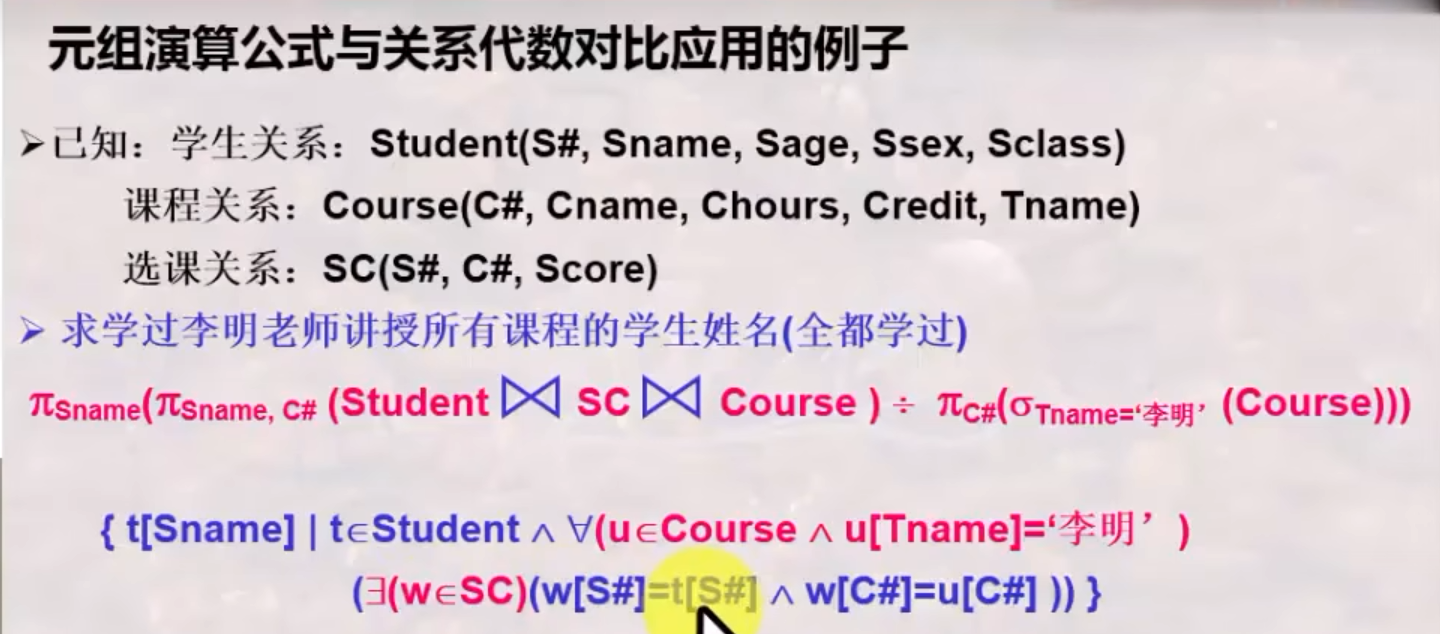
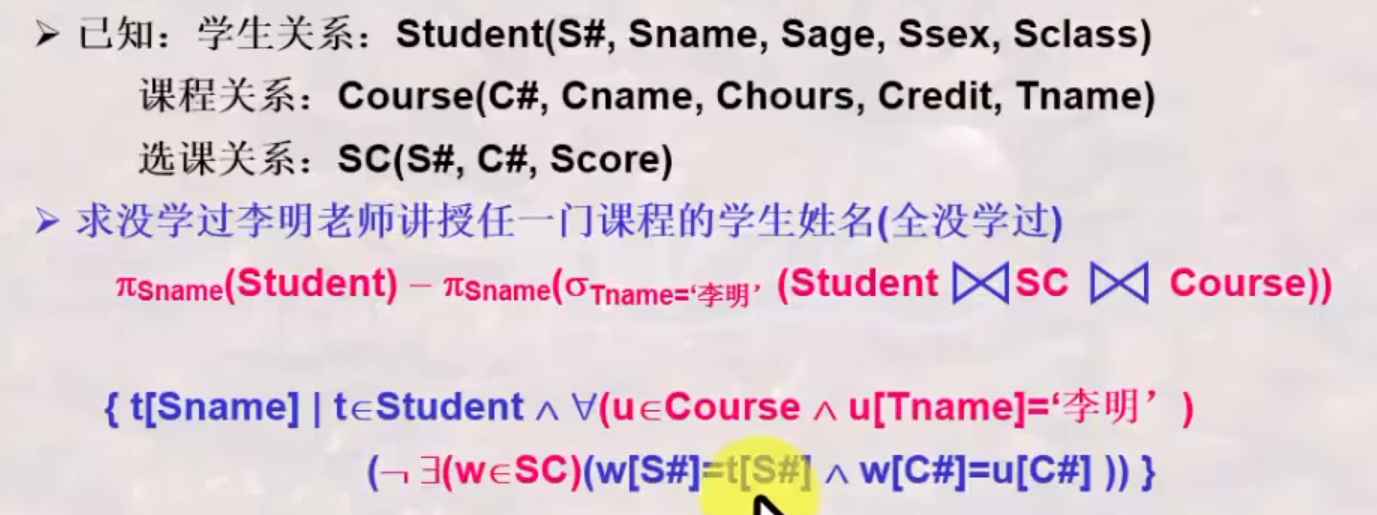
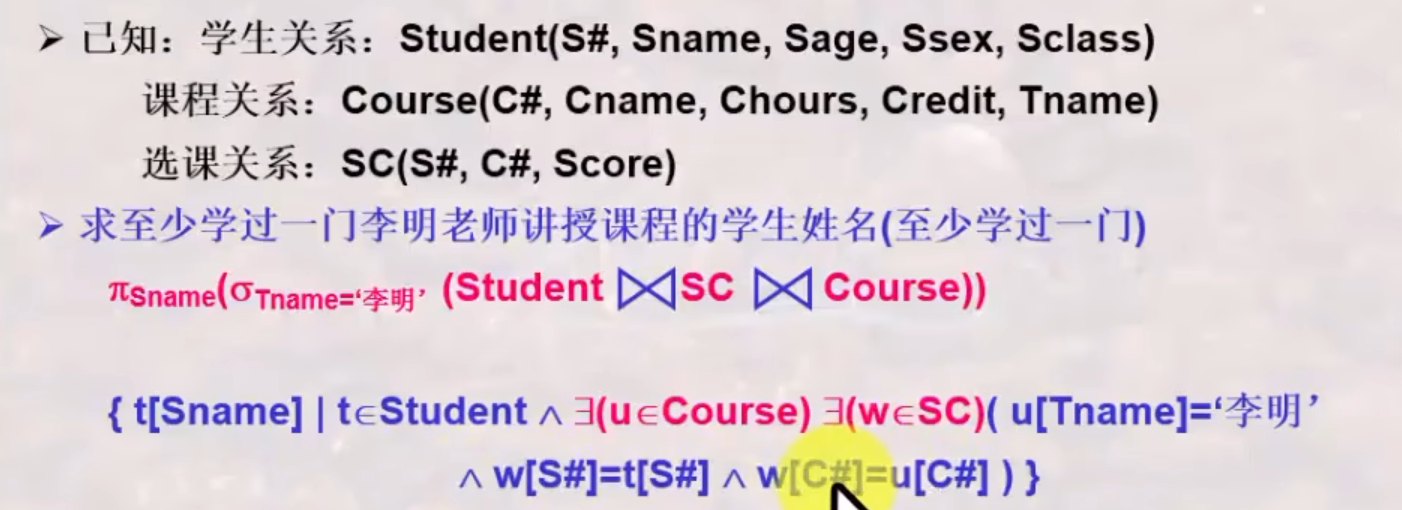
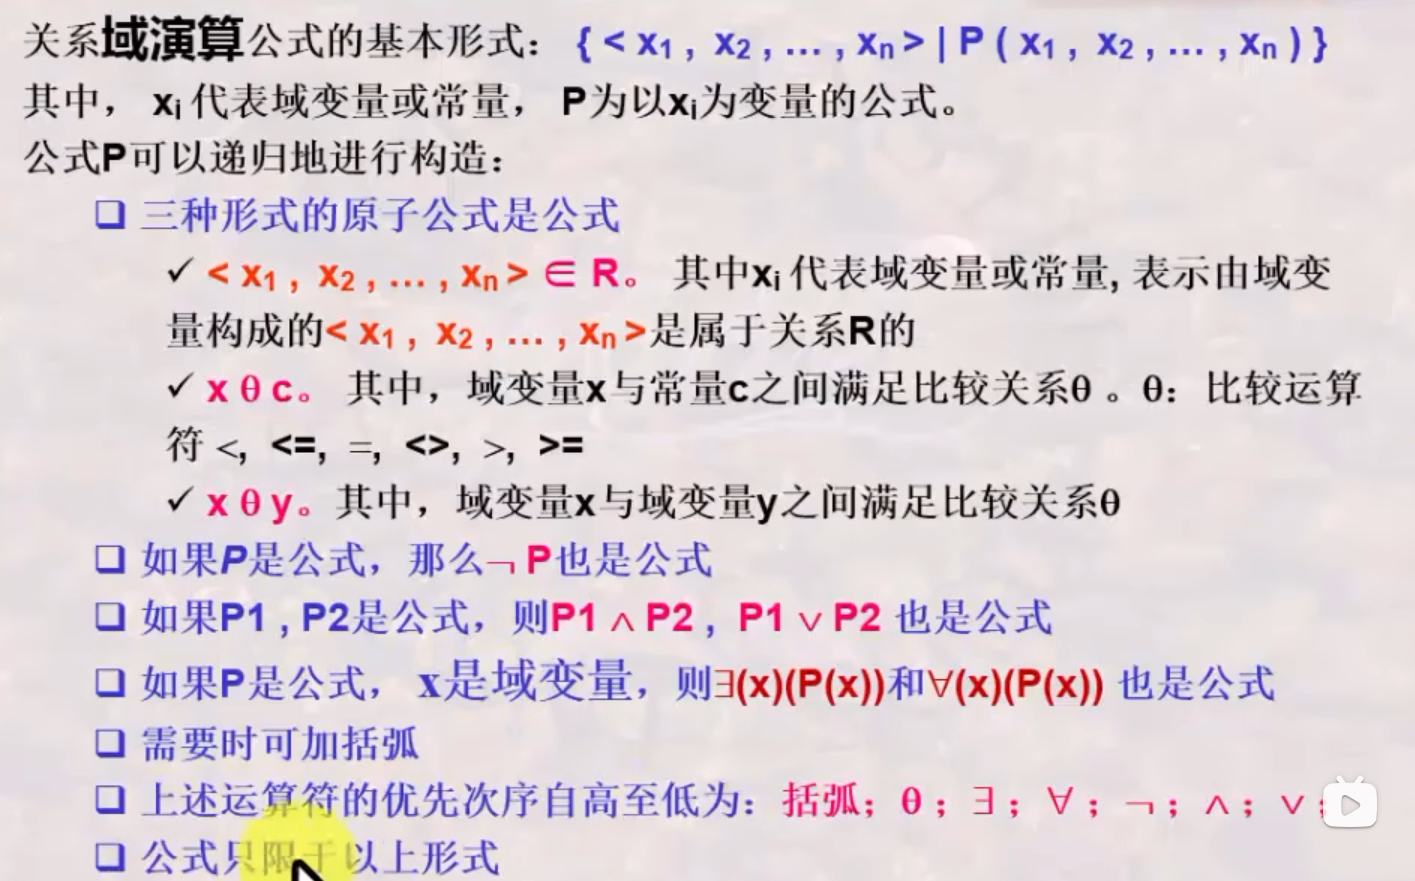
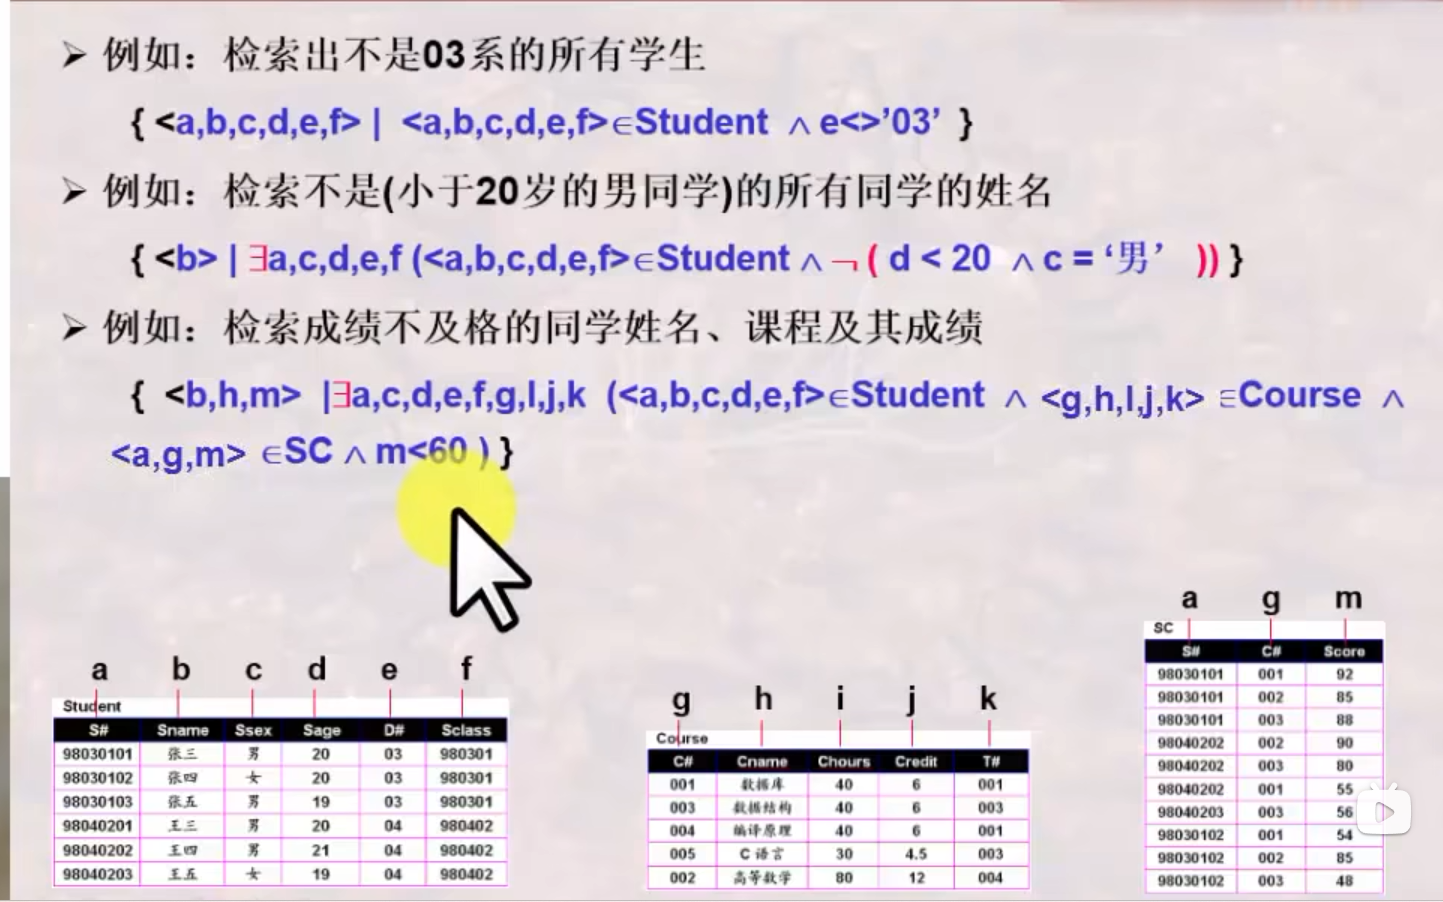
域关系演算
以域变量作为谓词变元的基本对象,表达式的一般形式是
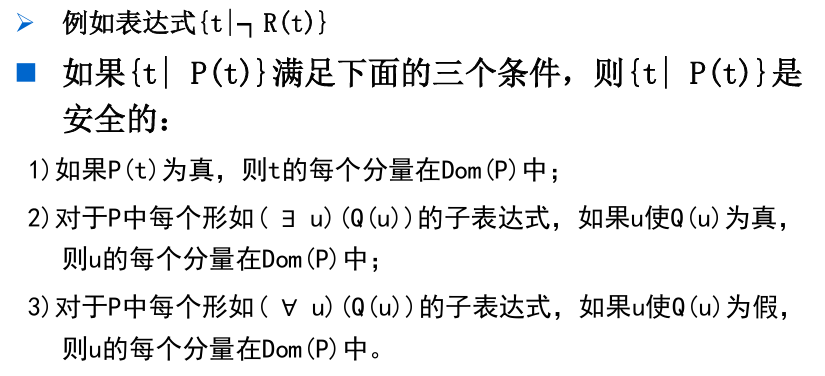
关系运算的安全性
不产生无限关系和无穷验证的表达式称为安全表达式,为了保证运算的安全性而采取的限制措施称为安全约束。
关系代数是一种集合运算,集合本身是有限的,有限元素集合的有限次运算也是有限的,所以是安全的。
关系演算不一定。
第3章 关系数据库语言SQL
3.1 SQL语言概述
结构化查询语言SQL(Structured Query Language)是一种介于关系代数与关系演算之间的语言,其功能包括查询、操纵、定义和控制四个方面,是一个通用的关系数据库语言。SQL于1974年由Boyce和Chamberlin提出,并在IBM公司的System R上实现。目前,SQL已成为关系数据库的标准语言。
SQL的特点
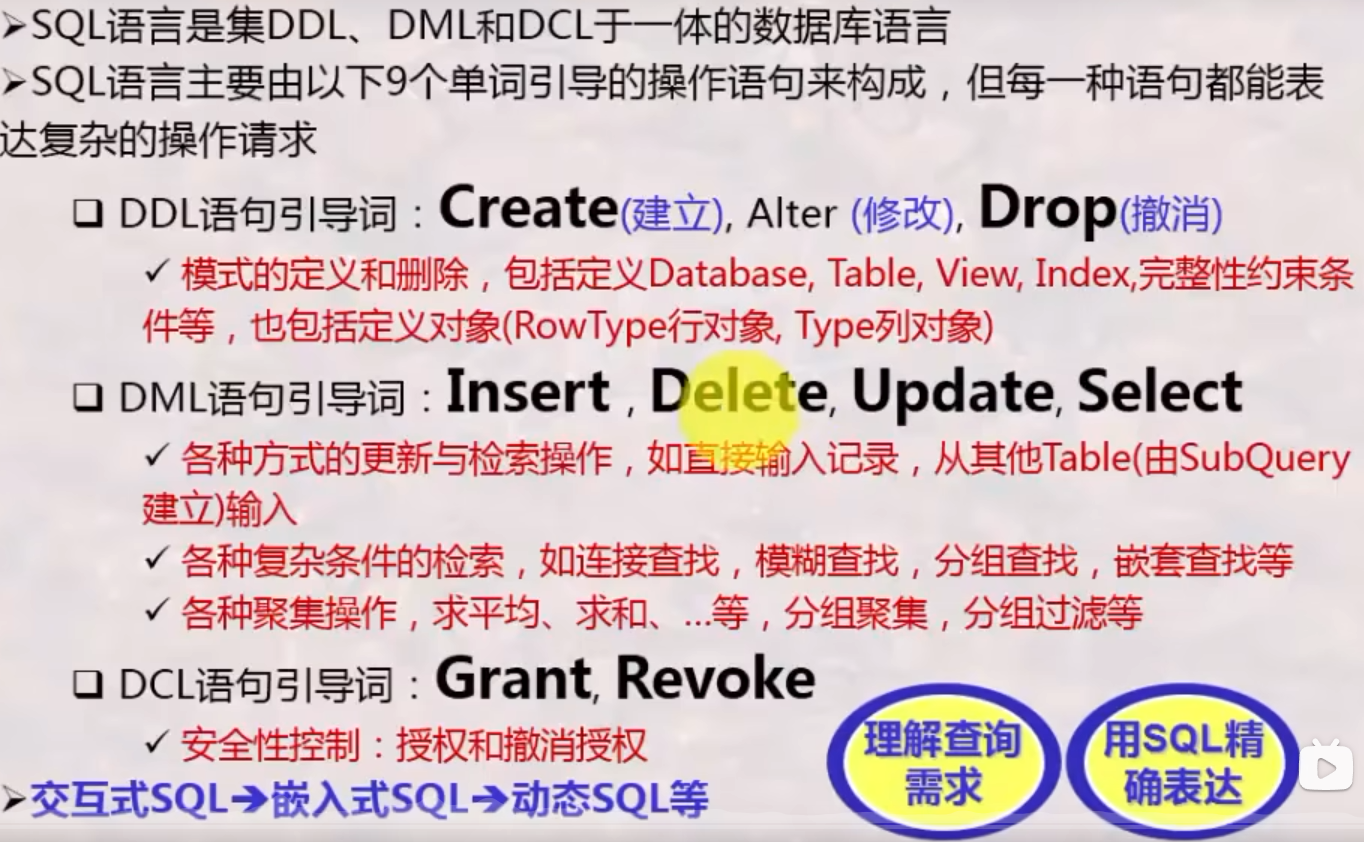
- 综合统一:集==数据定义语言(DDL),数据操纵语言(DML),数据控制语言(DCL)==功能于一体。可以独立完成数据库生命周期中的全部活动。
- 高度非过程化:SQL只要提出"做什么",无须了解存取路径。存取路径的选择以及SQL的操作过程由系统自动完成。
- 面向集合的操作方式:SQL采用集合操作方式,操作对象、查找结果可以是元组的集合。
- 以同一种语法结构提供多种使用方式:SQL既是独立的语言(能够独立地用于联机交互的使用方式),又是嵌入式语言(能够嵌入到高级语言程序中)。
- 语言简洁,易学易用:完成核心功能只用了9个动词。
SQL语言的动词:
| SQL功能 | 动词 |
|---|---|
| 数据查询 | SELECT |
| 数据定义 | CREATE,DROP,ALTER |
| 数据操纵 | INSERT,UPDATE,DELETE |
| 数据控制 | GRANT,REVOKE |
SQL的基本概念
- 基本表:本身独立存在的表,SQL中一个关系就对应一个基本表。一个(或多个)基本表对应一个存储文件。
- 存储文件:逻辑结构组成了关系数据库的内模式,物理结构是任意的,对用户透明。
- 视图:从一个或几个基本表导出的表。数据库中只存放视图的定义而不存放视图对应的数据,视图是一个虚表。用户可以在视图上再定义视图。
SQL的组成
- 数据定义语言(SQL DDL):用于定义SQL模式、基本表、视图、索引等结构
- 数据操纵语言(SQL DML):数据查询和数据更新(插入、删除和修改)
- 数据控制语言(SQL DCL):包括对基本表和视图的授权、完整性规则的描述、事务控制等
- 嵌入式SQL语言的使用规定
3.2 SQL数据定义语言
SQL的数据定义功能包括模式定义、表定义、视图和索引的定义。
创建基本表
CREATE TABLE <表名>(<列名> <数据类型> [完整性约束条件]
    [,<列名> <数据类型> [完整性约束条件]]
    ……
    [表级完整性约束条件]);
列的完整性约束条件:
NULL或NOT NULL:指定当前列是否可以取空值UNIQUE:指定当前列取值不可重复DEFAULT <表达式>:指定该列的缺省值
表级完整性约束:PRIMARY KEY (<列名>)FOREIGN KEY (<列名>) REFERENCES <表名> ON DELETE {RESTRICT | CASCADE | SET NULL}CHECK <逻辑条件表达式>
修改与删除基本表
- 修改:
ALTER TABLE <表名> [ADD <新列名> <数据类型> [完整性约束]] [DROP <完整性约束名>] [MODIFY <列名> <数据类型>]; - 删除:
DROP TABLE <表名>;(基本表定义一旦删除,表中的数据、在此表上建立的索引都将自动被删除掉)
索引
RDBMS中索引一般采用B+树、HASH索引来实现。B+树索引具有动态平衡的优点,HASH索引具有查找速度快的特点。索引是关系数据库的内部实现技术,属于内模式的范畴。
创建索引:CREATE [UNIQUE] [CLUSTER] INDEX <索引名> ON <表名> (<列名> [ASC | DESC] [,...]);
删除索引:DROP INDEX <索引名>;
建立索引的目的:加快查询速度。DBMS一般会自动建立PRIMARY KEY和UNIQUE列上的索引。使用索引时,DBMS自动选择是否使用索引以及使用哪些索引。
3.3 SQL数据查询语言
基本查询格式
SELECT [ALL|DISTINCT] <目标列表达式> [,<目标列表达式>]...
FROM <表名或视图名> [,<表名或视图名>] ...
[WHERE <条件表达式>]
[GROUP BY <列名1> [HAVING <条件表达式>]]
[ORDER BY <列名2> [ASC|DESC]];
整个SELECT语句的含义:根据WHERE子句的条件表达式,从FROM子句指定的基本表或视图中找出满足条件的元组,再按SELECT子句中的目标列表达式,选出元组中的属性值形成结果表。
常用查询条件
| 查询条件 | 谓词 |
|---|---|
| 比较 | =,>,<,>=,<=,!=,<>,!>,!<;NOT+上述比较运算符 |
| 确定范围 | BETWEEN AND,NOT BETWEEN AND |
| 确定集合 | IN,NOT IN |
| 字符匹配 | LIKE,NOT LIKE |
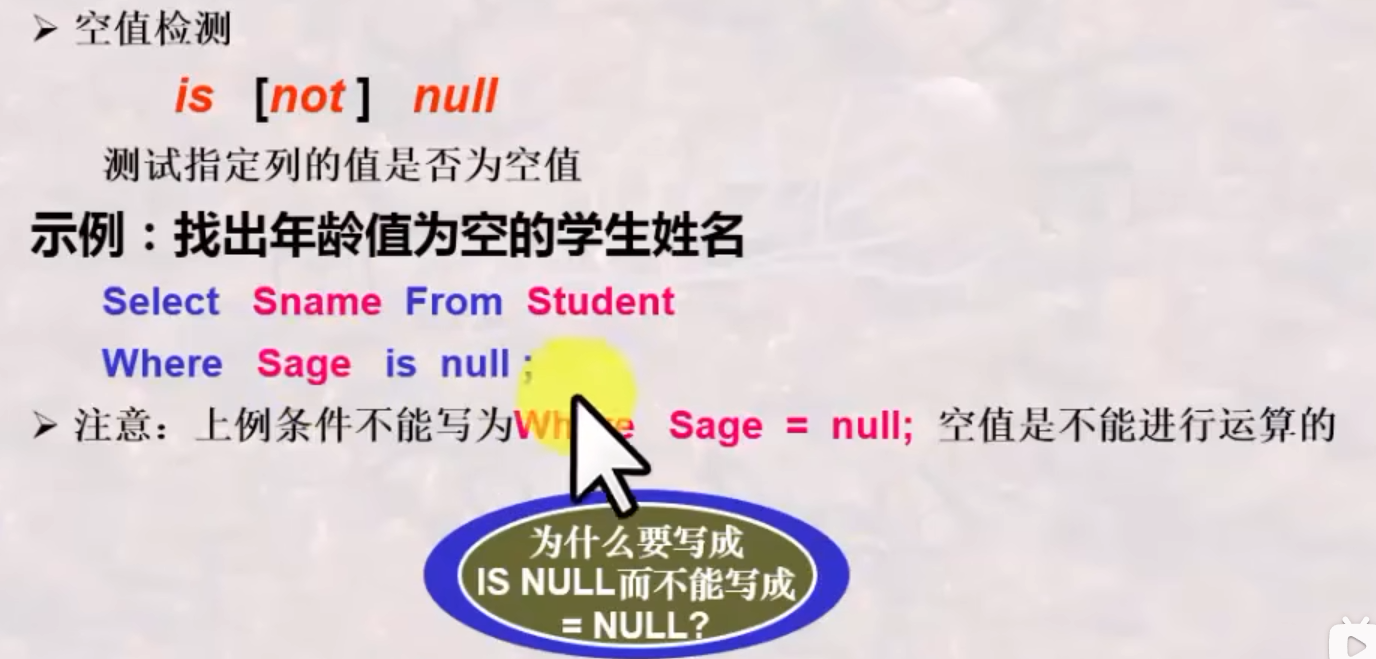
| 空值 | IS NULL,IS NOT NULL |
| 多重条件(逻辑运算) | AND,OR,NOT |
| 字符匹配中: |
%:代表任意长度(可以为0)的字符串_:代表任意单个字符ESCAPE '\':表示\为换码字符,用于将通配符转义为普通字符
嵌套查询
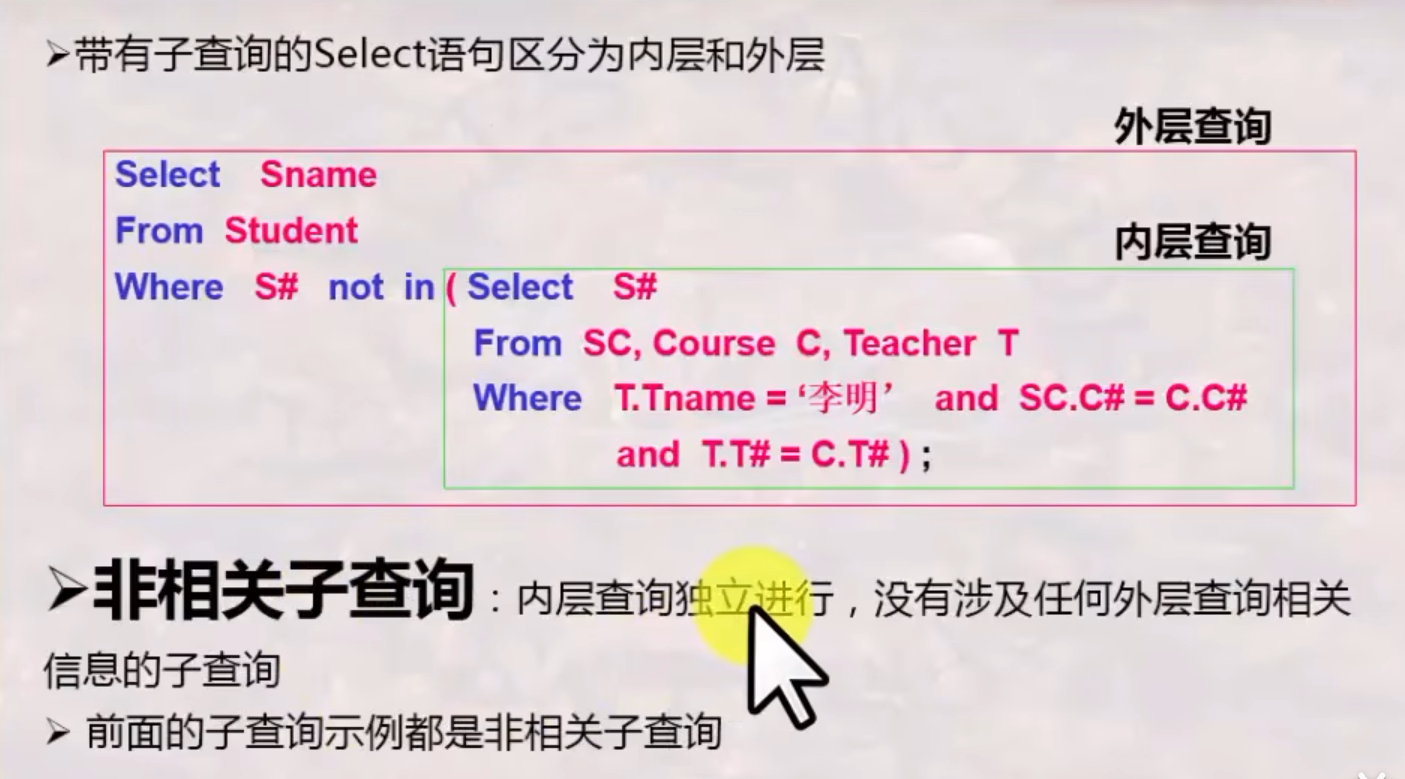
将一个查询块嵌套在另一个查询块的WHERE子句或HAVING短语的条件中的查询称为嵌套查询。
- 不相关子查询:子查询的条件不依赖于父查询。由里向外逐层处理。
- 相关子查询:子查询的查询条件依赖于父查询。首先取外层查询中表的第一个元组,根据它与内层查询相关的属性值处理内层查询,若WHERE子句返回值为真,则取此元组放入结果表;然后再取外层表的下一个元组。
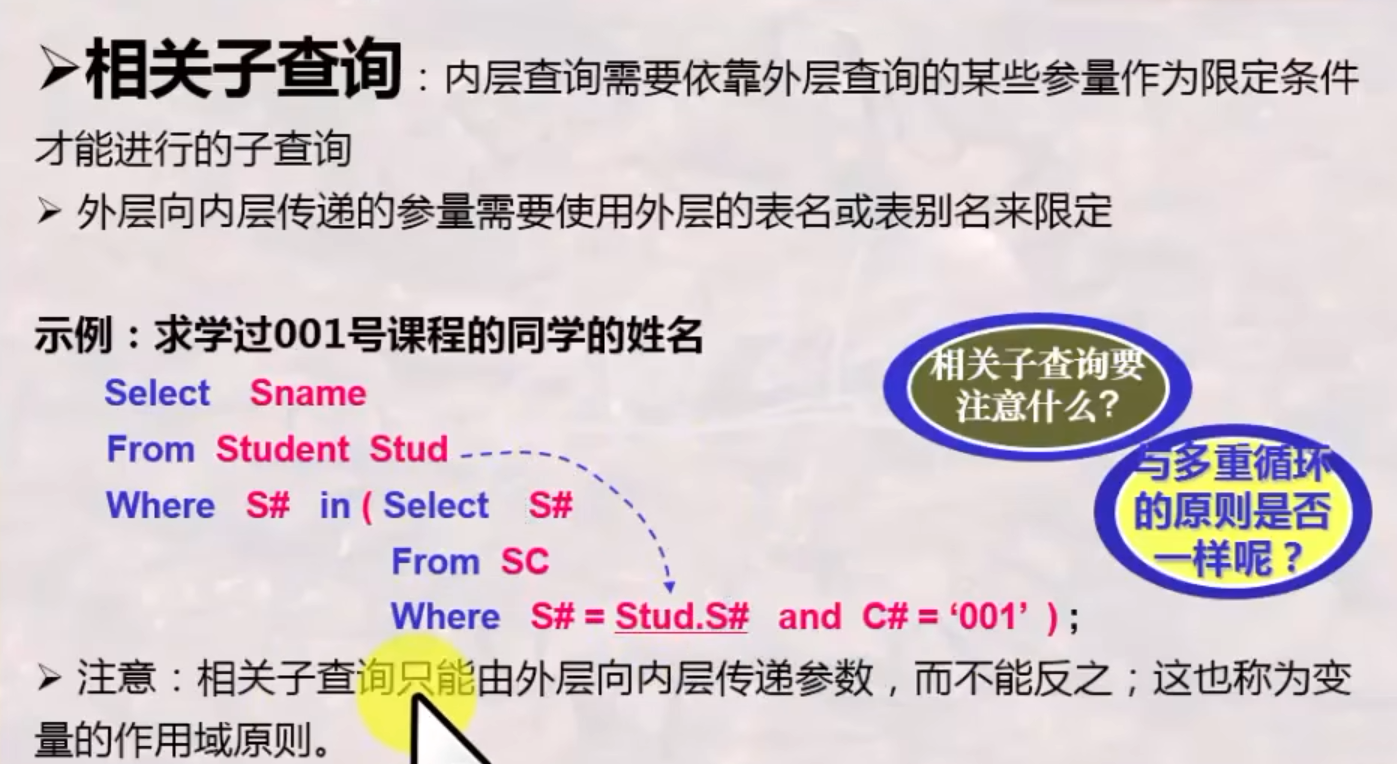
子查询的限制:不能使用ORDER BY子句。
子查询谓词: IN:检查是否在子查询结果中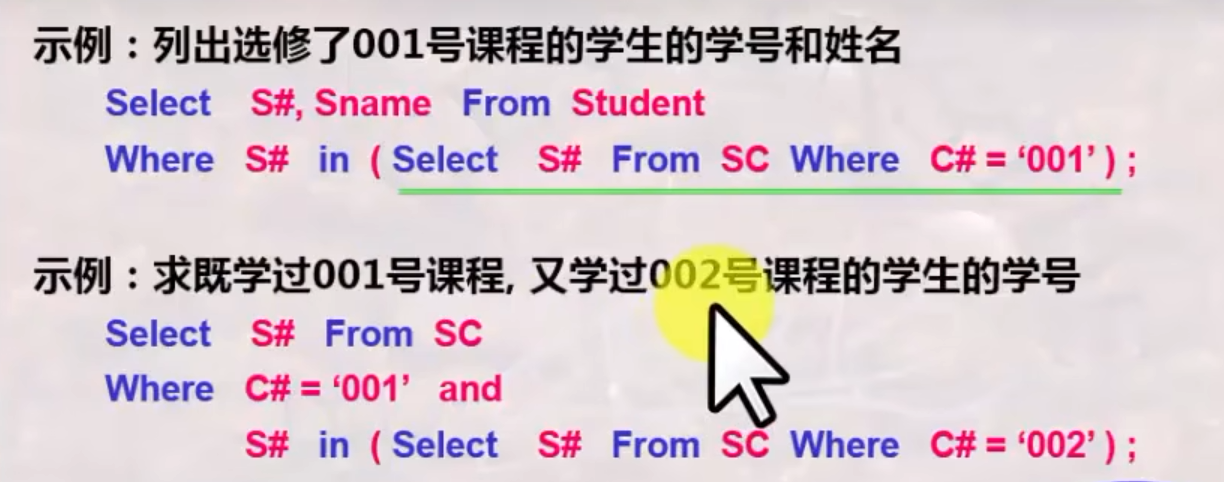
- 比较运算符配合
SOME(ANY)或ALL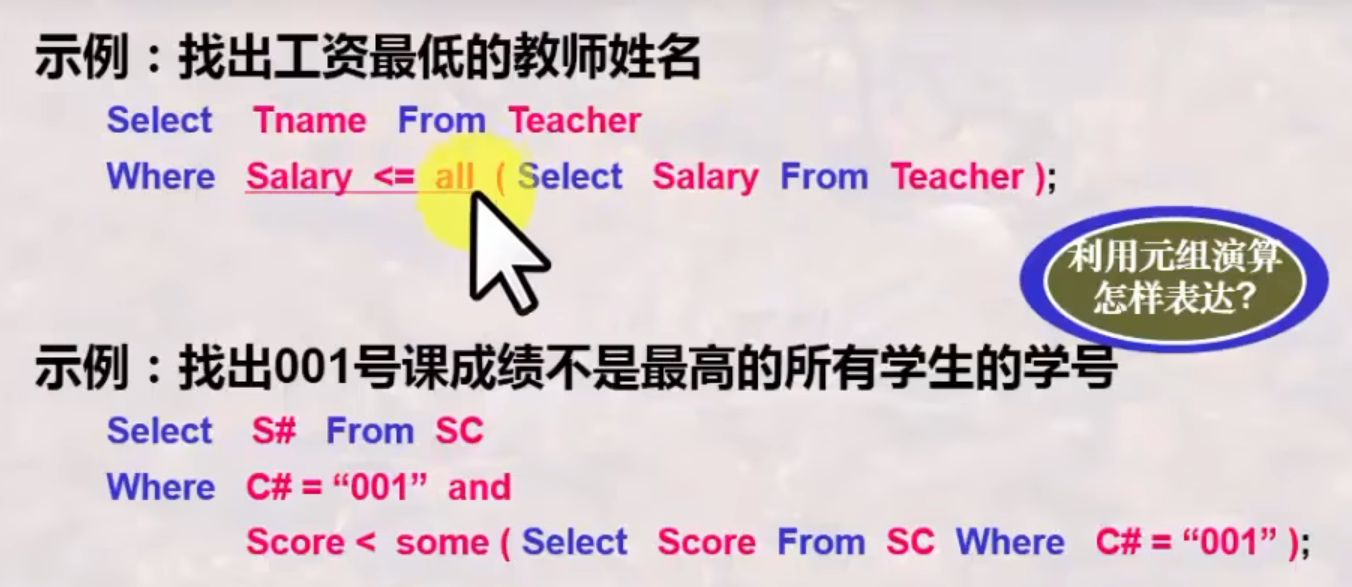
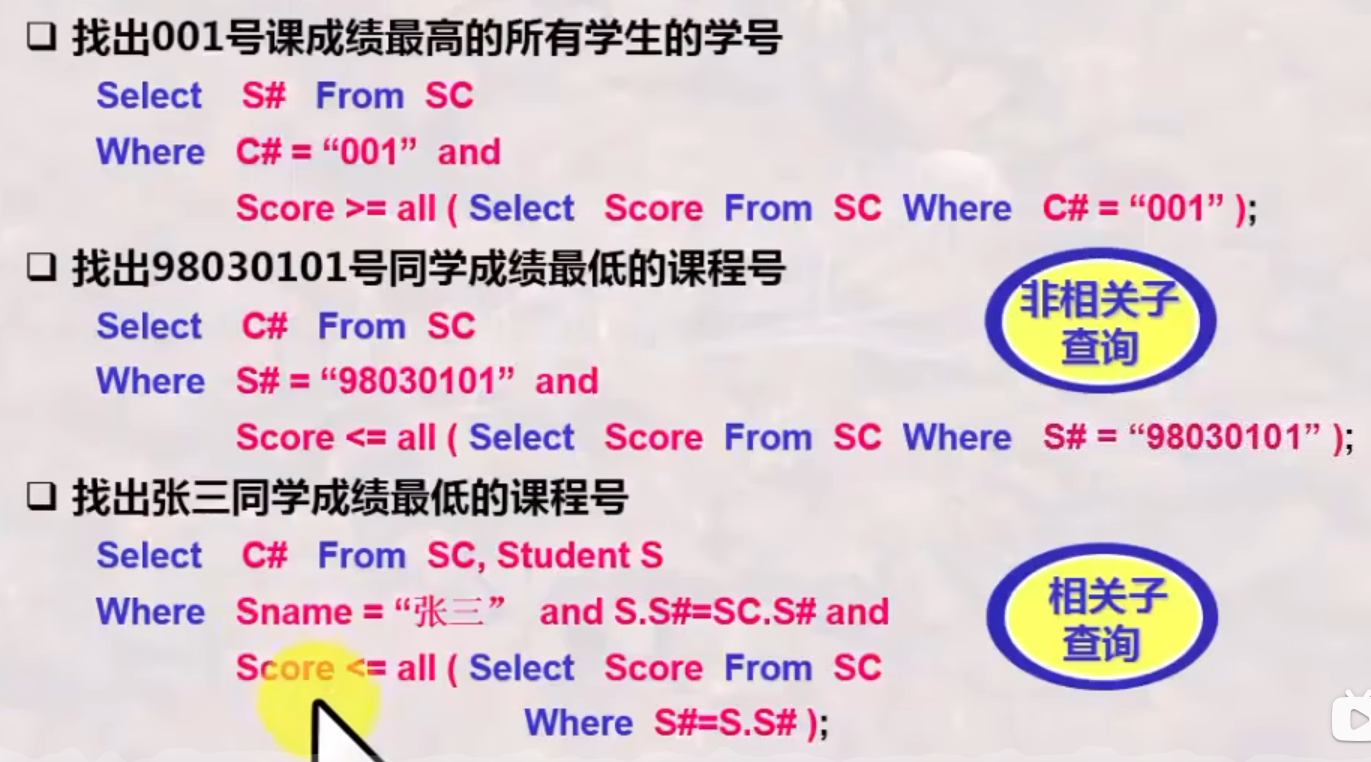
EXISTS/NOT EXISTS:存在量词,不返回任何数据,只产生逻辑真值"true"或逻辑假值"false"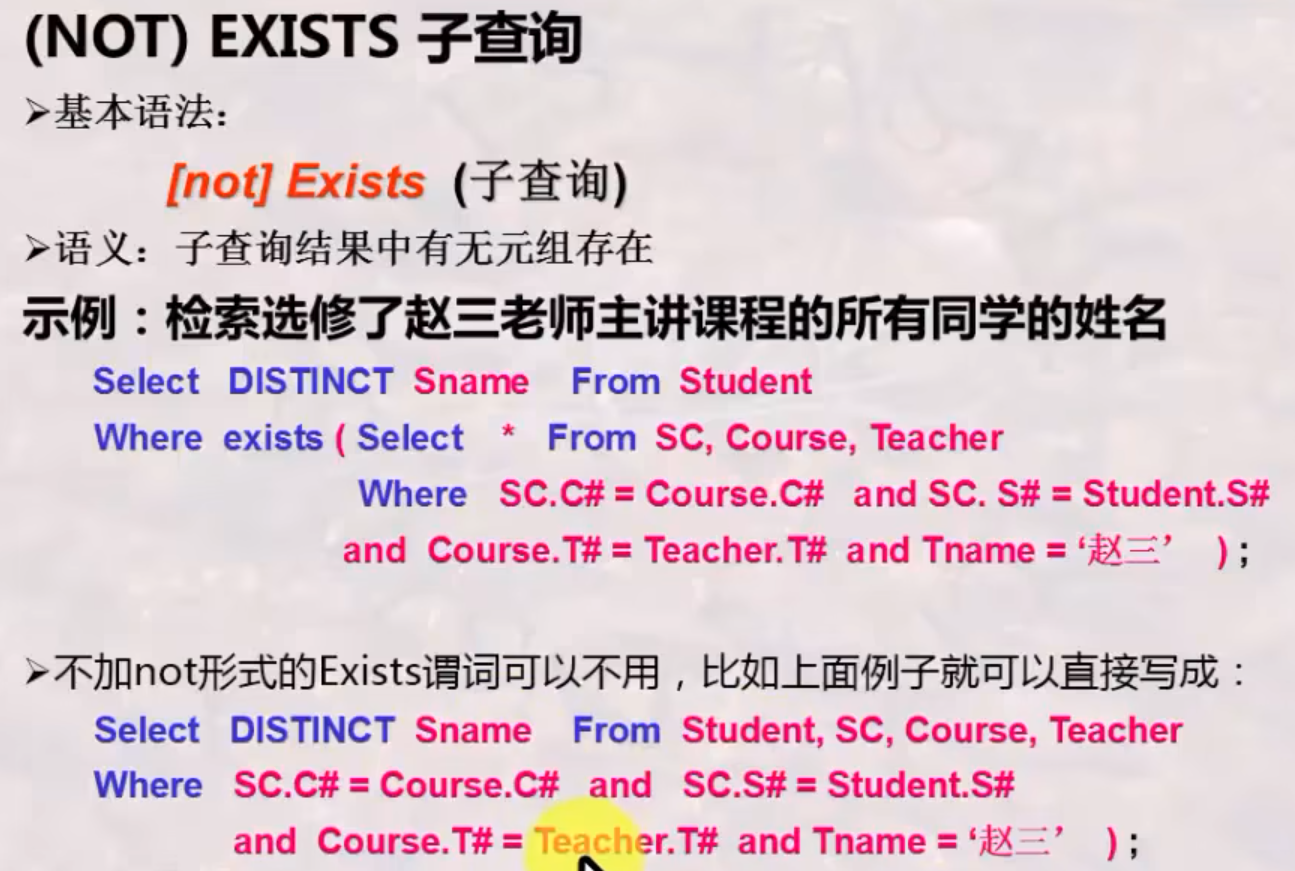
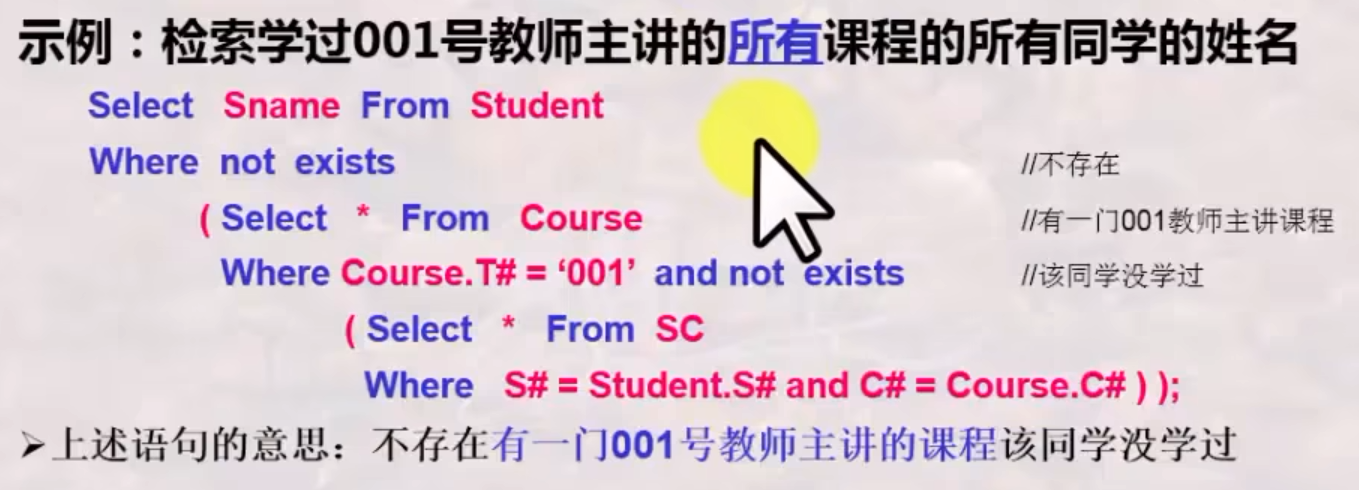
对于这个学生,不存在说001老师的课程,在sc表中找不到对应记录
SOME/ALL与聚集函数的等价关系:
| | = | <>或!= | < | <= | > | >= |
|---|---|---|---|---|---|---|---|
| SOME | IN | -- | <MAX | <=MAX | >MIN | >= MIN |
| ALL | -- | NOT IN | <MIN | <= MIN | >MAX | >= MAX |
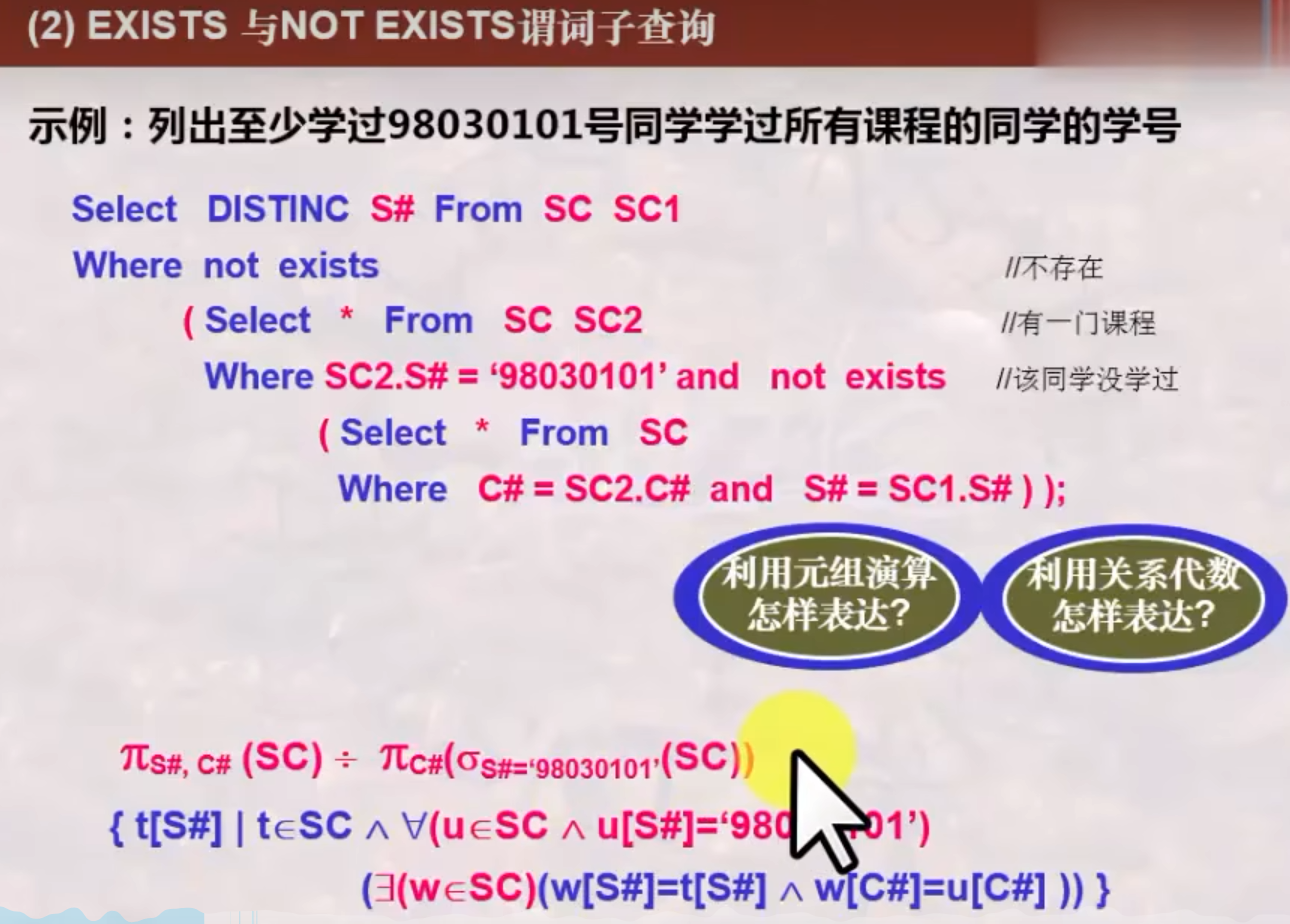
用EXISTS/NOT EXISTS实现全称量词:
SQL语言中没有蕴函(Implication)逻辑运算,可以利用谓词演算将逻辑蕴函谓词等价转换为:
SQL函数
SQL函数可以分为标量函数和聚集函数两类。
聚集函数:
COUNT([DISTINCT|ALL] *)或COUNT([DISTINCT|ALL] <列名>):计数SUM([DISTINCT|ALL] <列名>):计算总和AVG([DISTINCT|ALL] <列名>):计算平均值MAX([DISTINCT|ALL] <列名>):最大值MIN([DISTINCT|ALL] <列名>):最小值
分组查询与分组过滤
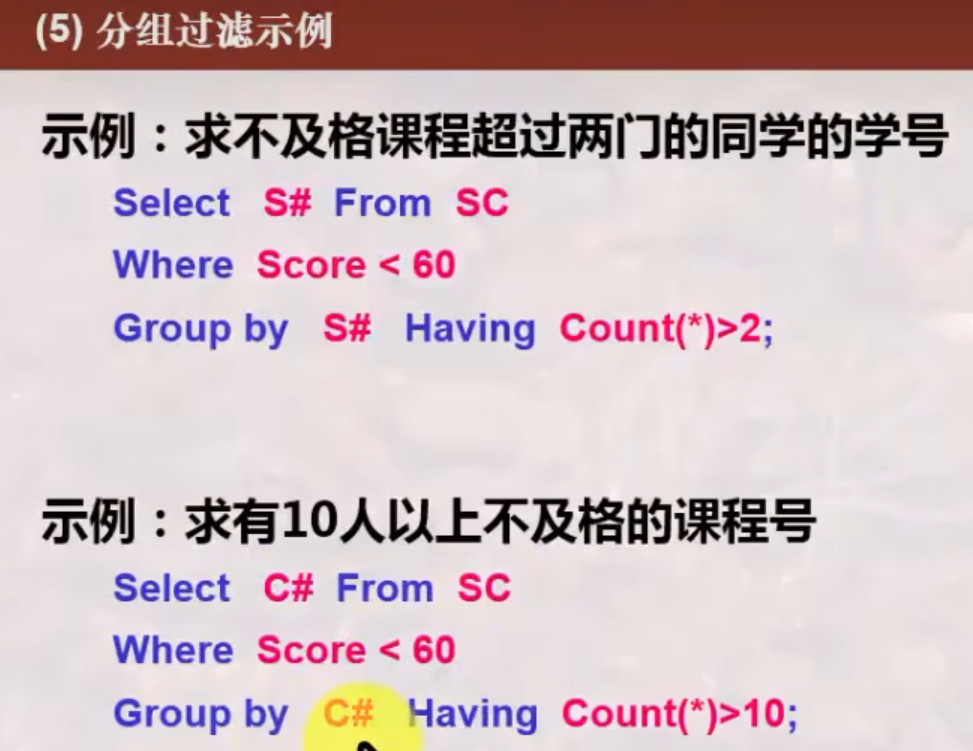
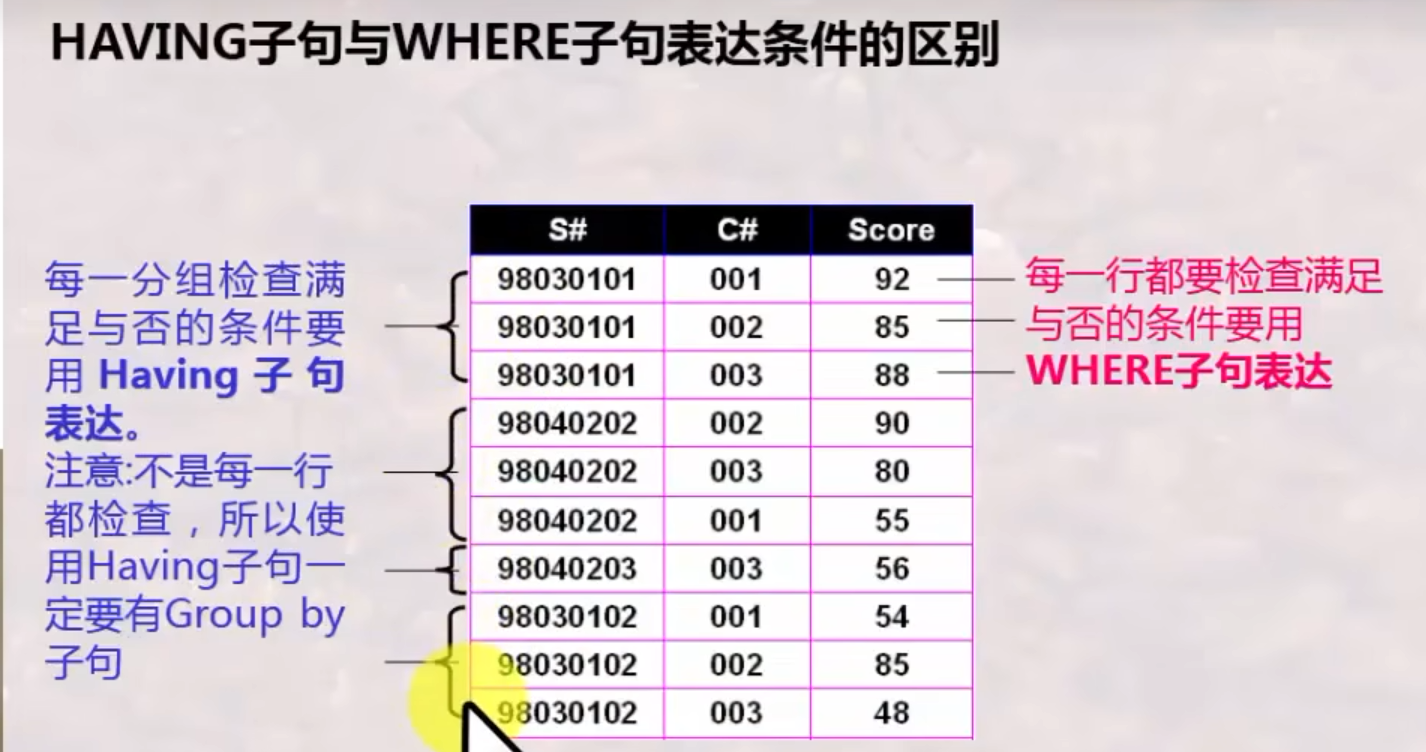
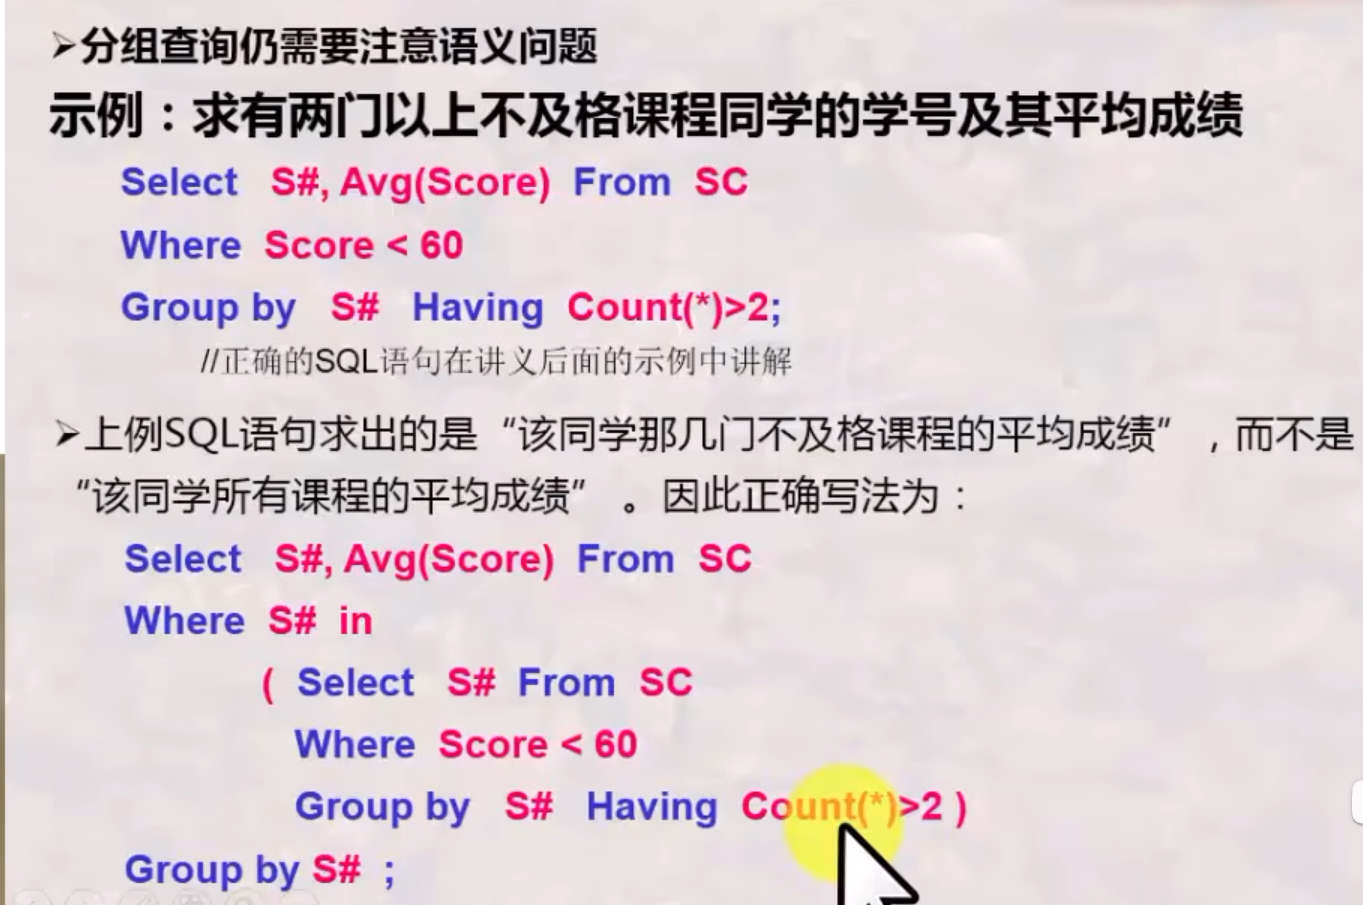
GROUP BY子句分组:细化聚集函数的作用对象。未对查询结果分组时,聚集函数将作用于整个查询结果;对查询结果分组后,聚集函数将分别作用于每个组。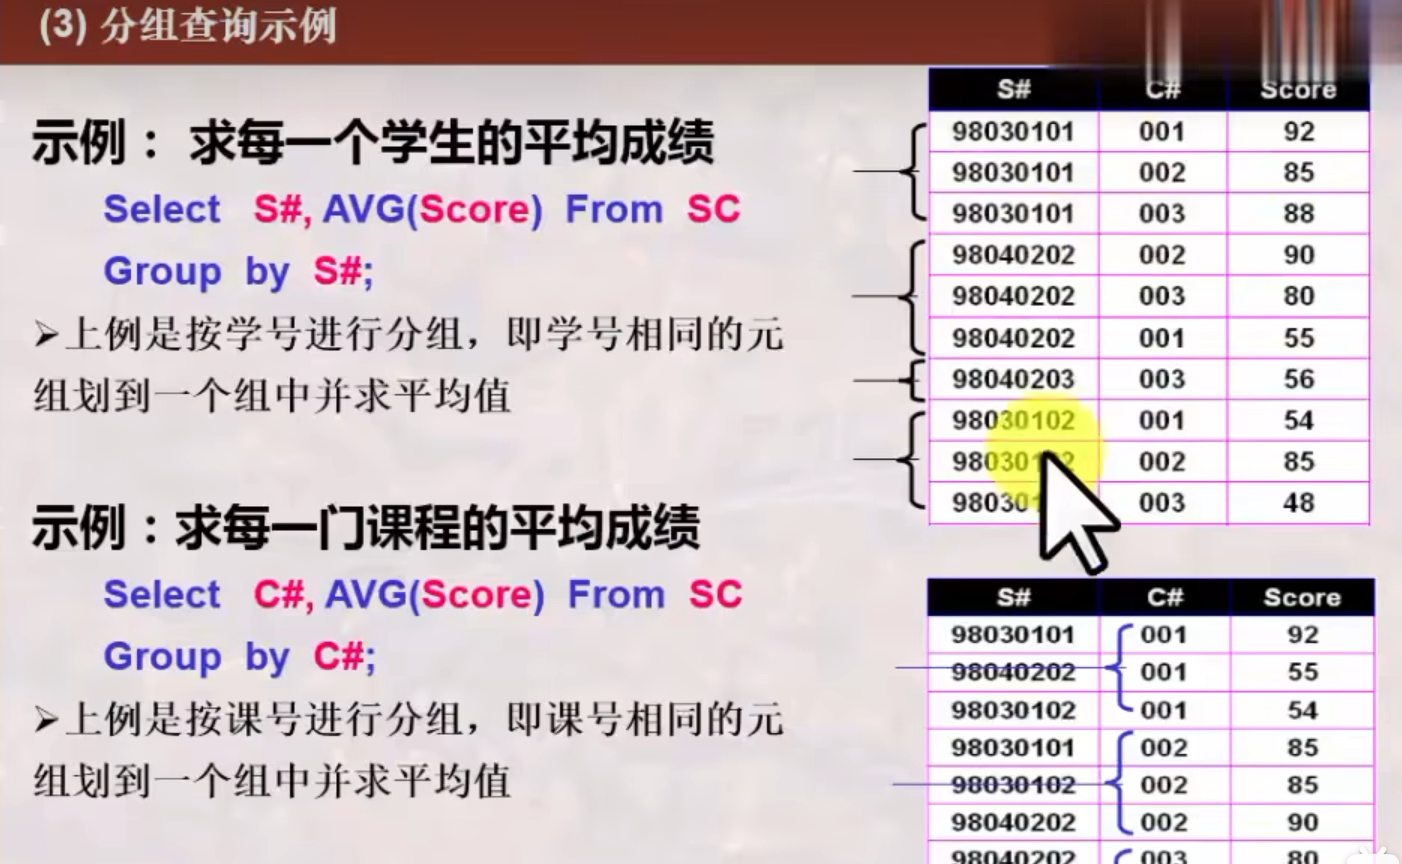
HAVING短语:作用于组,从中选择满足条件的组。注意与WHERE子句的区别——WHERE子句作用于基表或视图,从中选择满足条件的元组。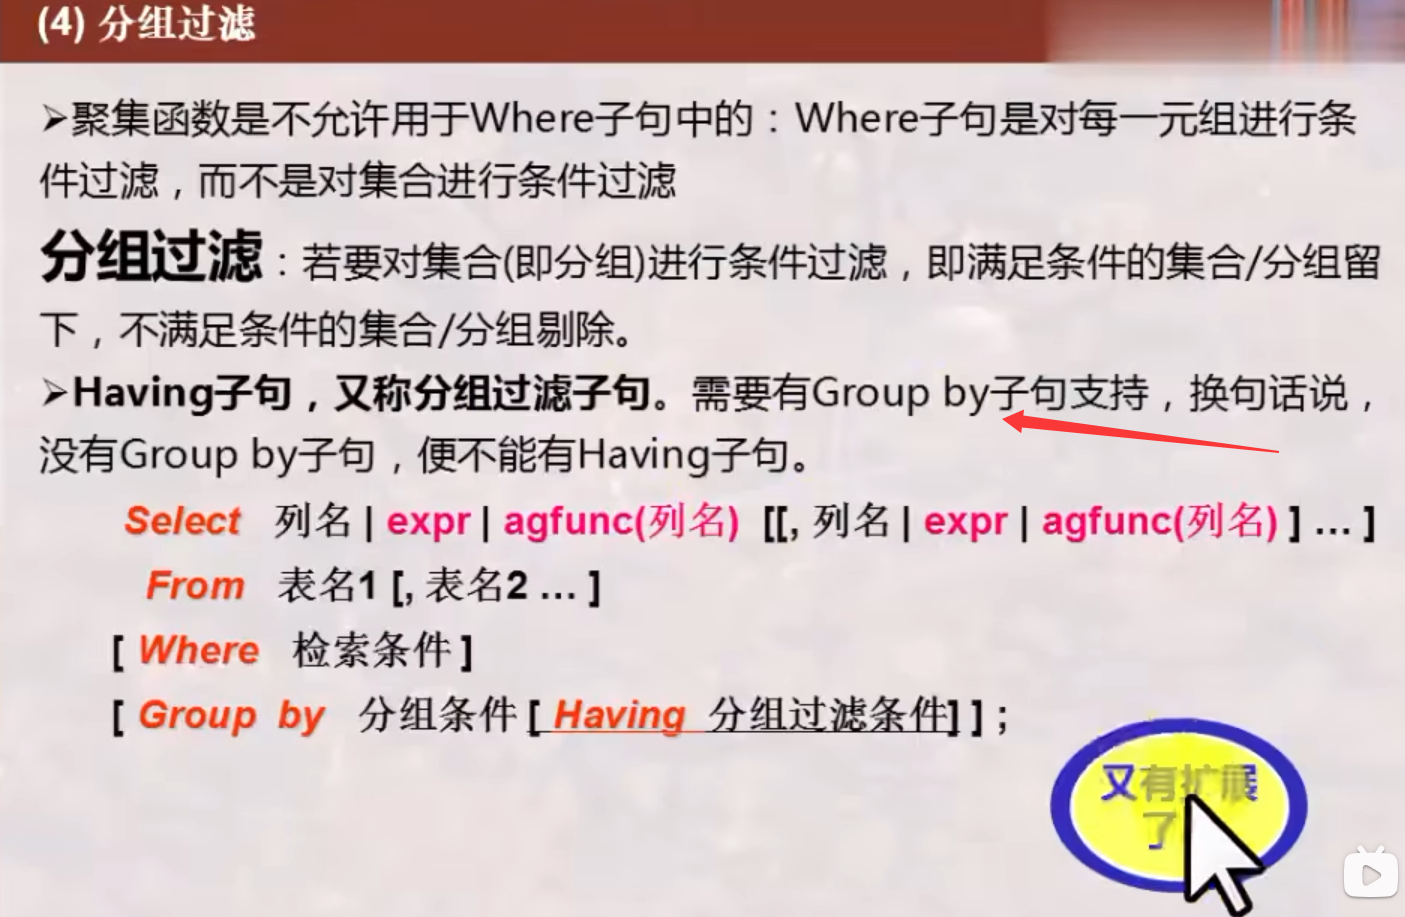
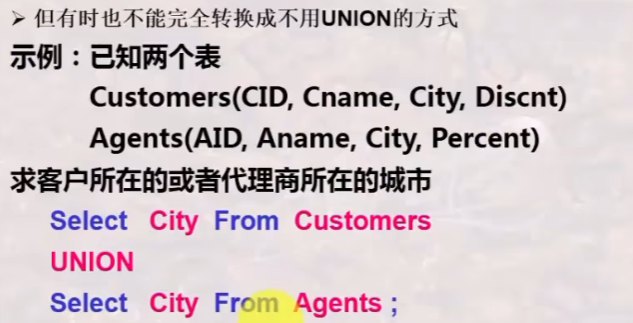
集合查询
UNION:并操作,系统自动去掉重复元组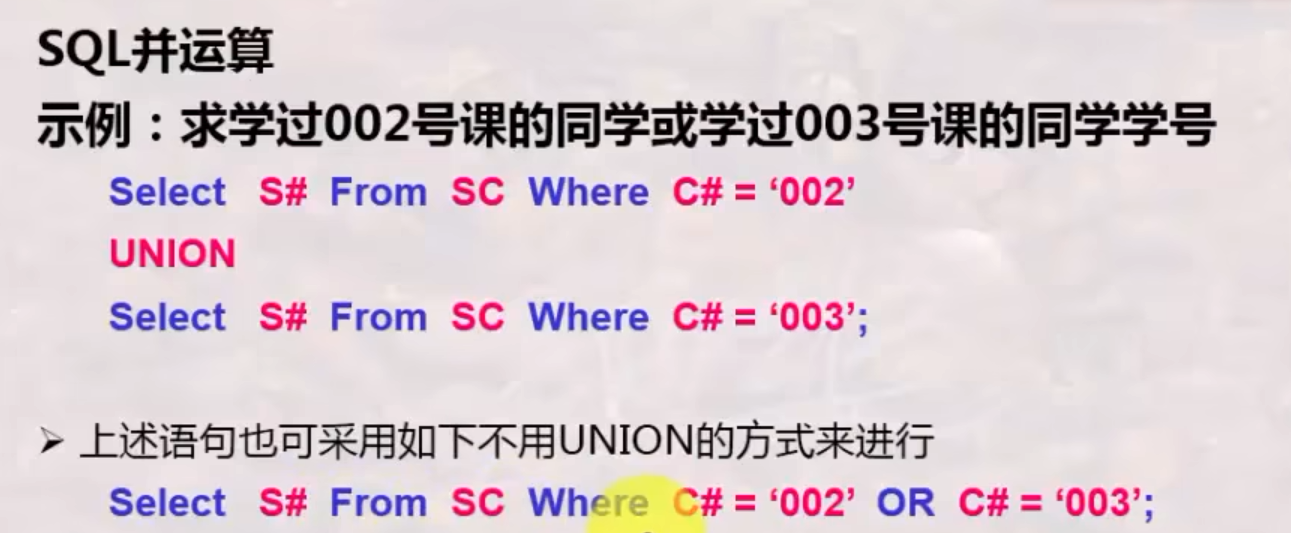
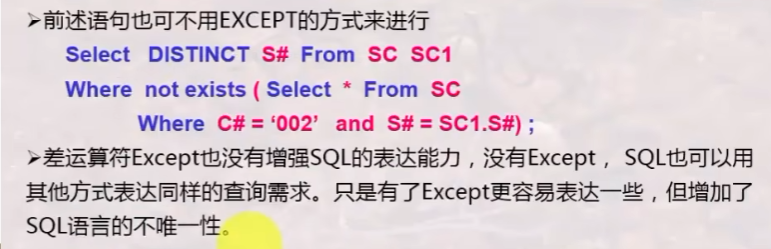
UNION ALL:并操作,保留重复元组INTERSECT:交操作EXCEPT:差操作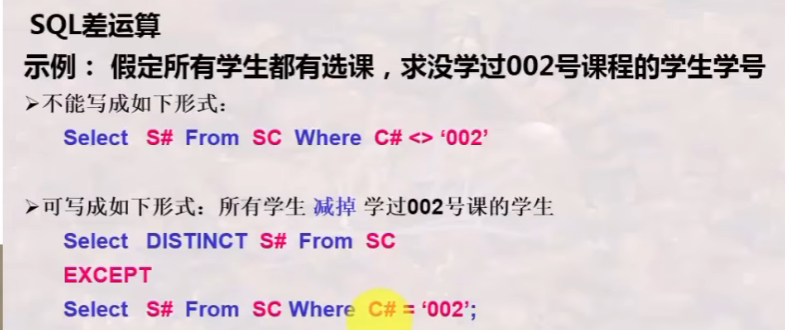
参加集合操作的各查询结果的列数必须相同;对应项的数据类型也必须相同。
连接查询
- 等值连接:连接运算符为
= - 自然连接:消除重复属性的等值连接
- 自连接:一个表与其自己进行连接,需要给表起别名以示区别
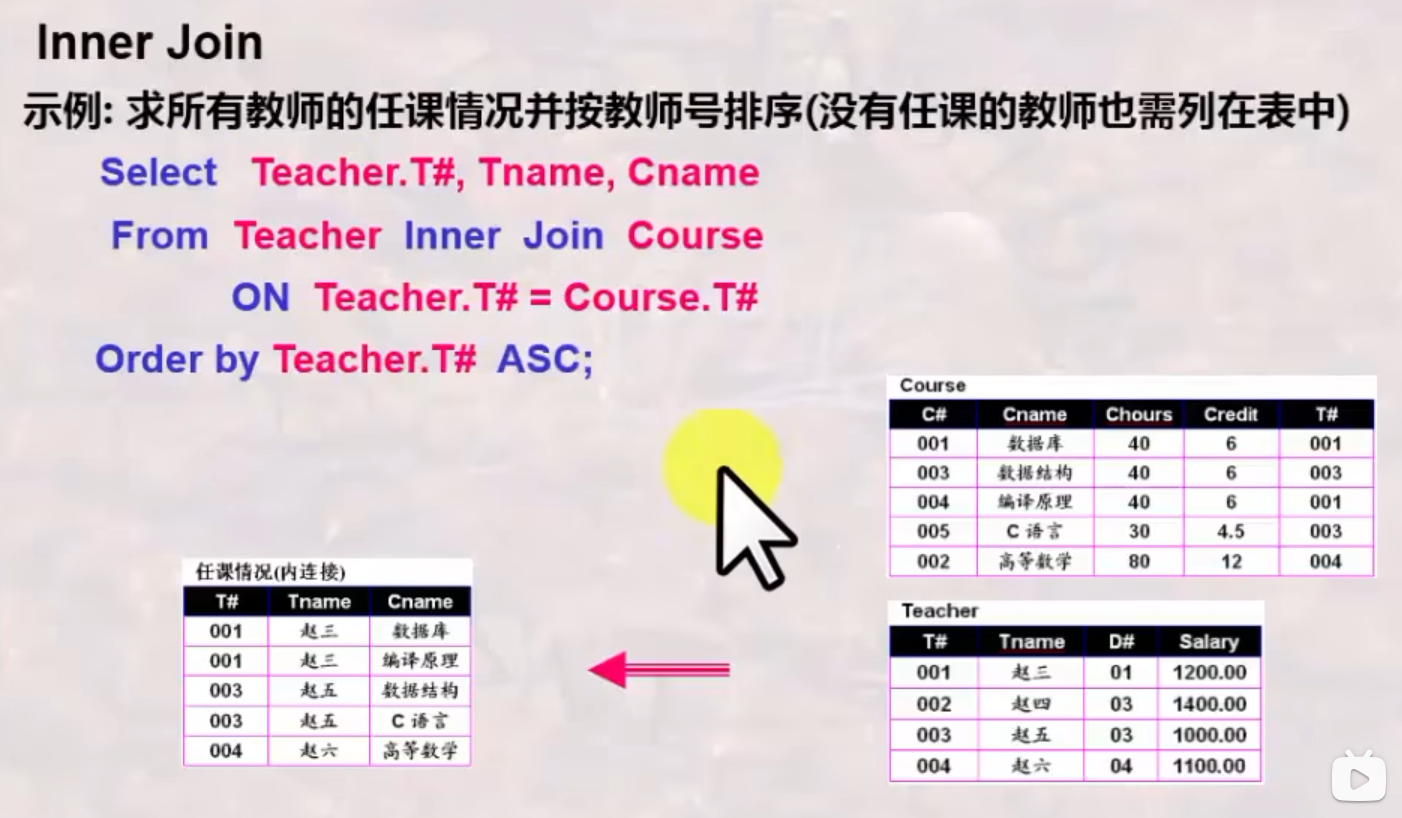
- 外连接:以指定表为连接主体,将主体表中不满足连接条件的元组一并输出
- 复合条件连接:WHERE子句中含多个连接条件
3.4 SQL数据操纵语言
数据插入
单记录插入:
INSERT INTO <表名> [(列名,…列名)] VALUES (列值,…列值);
多记录插入(SQL3):INSERT INTO <表名> [(列名,…列名)] VALUES (列值,…列值),…,(列值,…列值);
子查询结果插入:
INSERT INTO <表名> [(列名,…列名)] <子查询>;
数据删除
DELETE FROM <表名> [WHERE 条件表达式];
如果该语句指定WHERE条件,则只有满足条件的那些记录才会被删除,条件可以是简单的算术比较表达式,也可以是带有子查询的复杂形式。
数据修改
UPDATE <表名>
SET <列名>=<列值表达式>[,<列名>=<列值表达式>…]
[WHERE 条件表达式];
3.5 SQL视图
SQL视图是不存储具体数据,而仅在数据目录中存放其定义的"虚表",提供了一种间接访问基本表中数据的便捷方式。视图可以通过基本表或其它视图导出。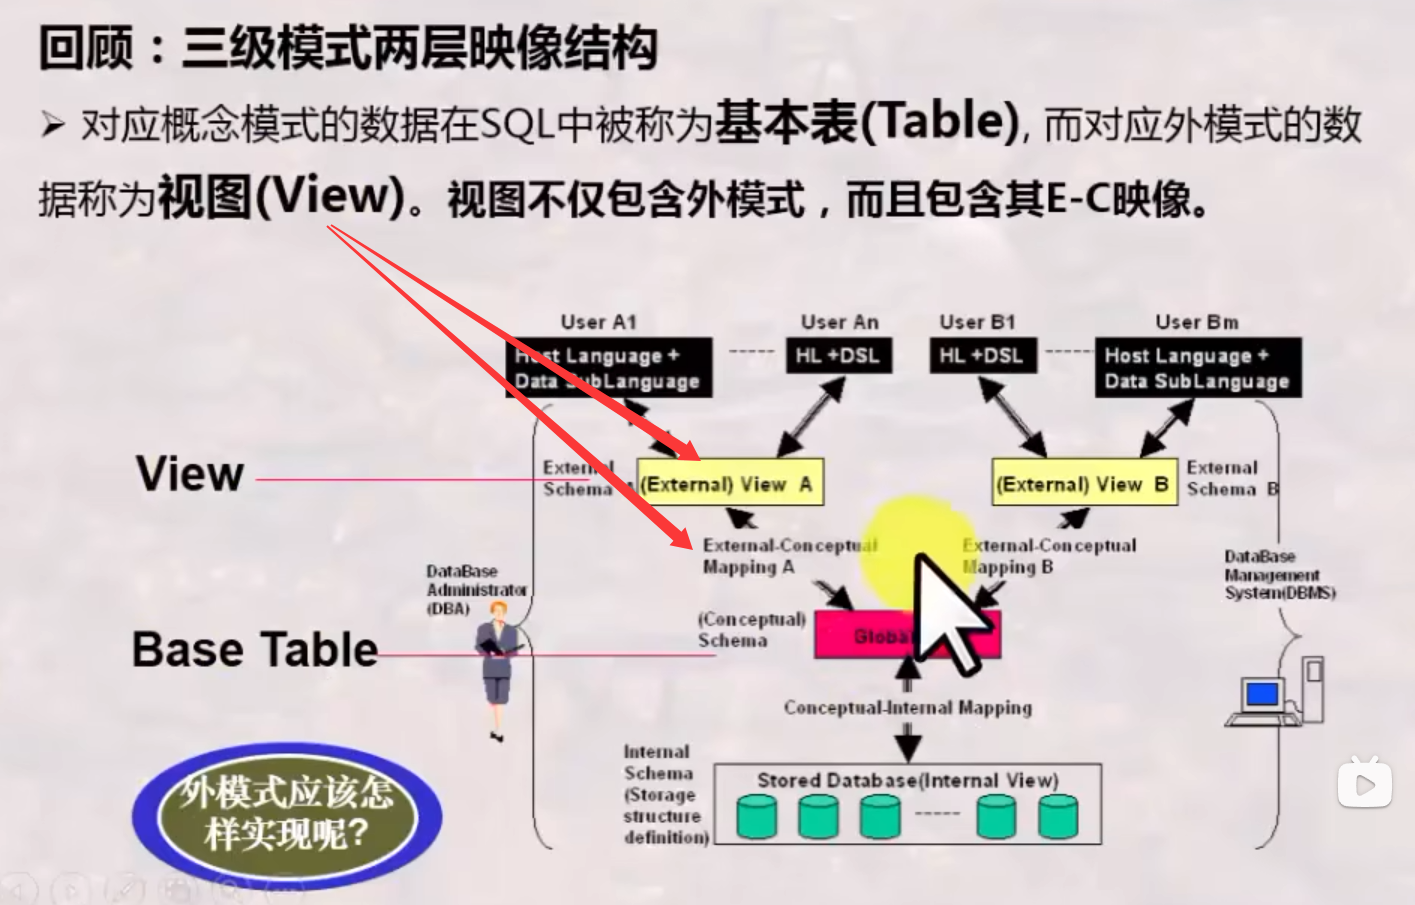
视图的定义
CREATE VIEW <视图名>[ (<列名>,…,<列名>)] AS <子查询> [WITH CHECK OPTION];
如果在子查询的SELECT语句中使用了函数或运算表达式,那么必须在视图名后给出全部的列名表,因为函数和运算表达式是不能用来表示一个列的名称的。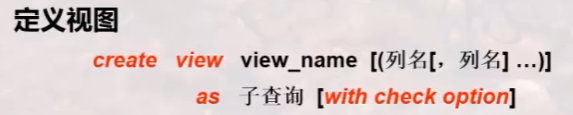
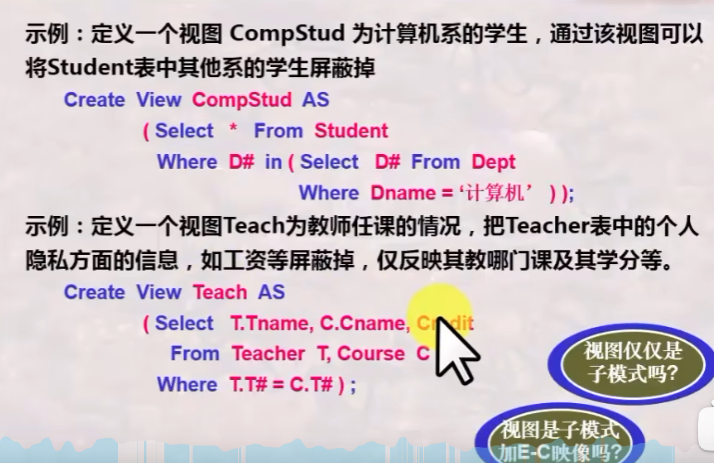
这里的子查询就是EC映像?
视图的查询
由于视图中并不存储数据记录,因此处理视图查询时系统会首先将视图查询语句中的WHERE条件与视图定义中的WHERE条件进行有效合并,然后再转变为对基本表的查询。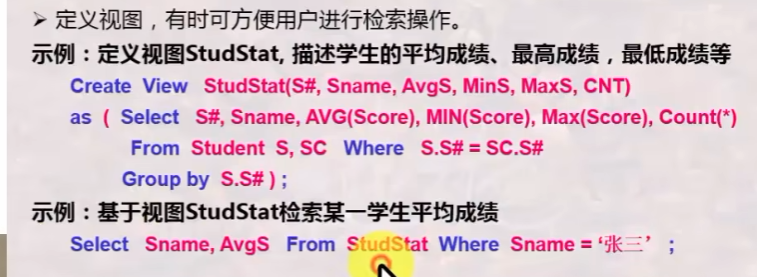
视图的更新
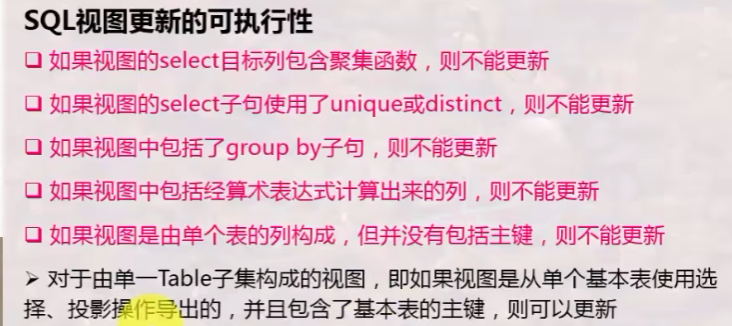
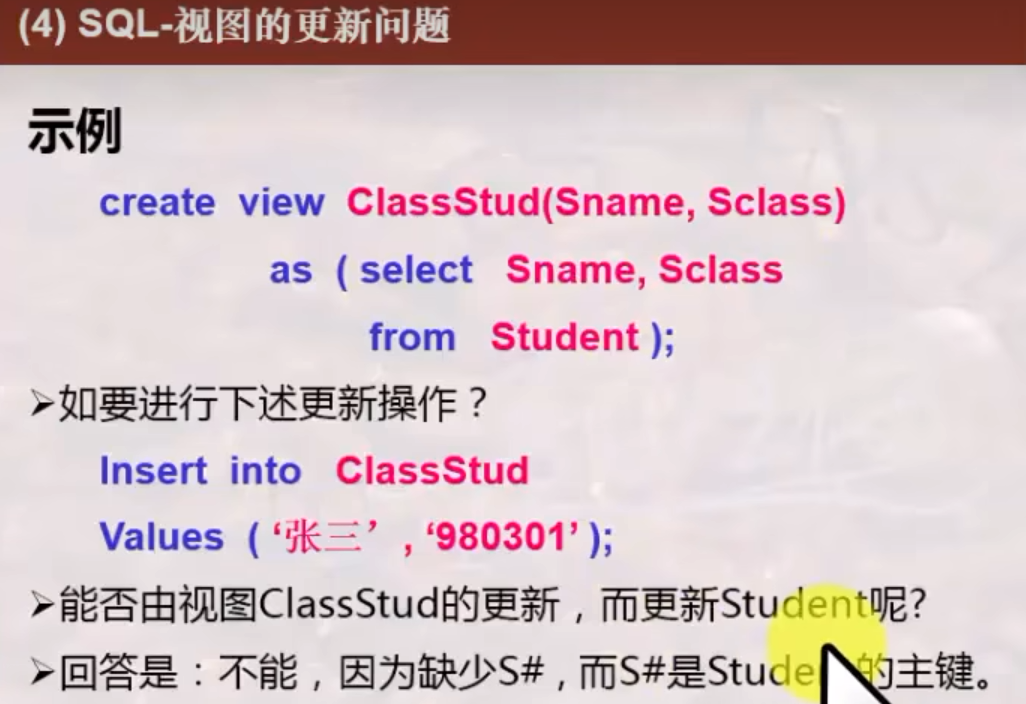
视图的更新(包括INSERT、UPDATE、DELETE等操作)往往会具有较大的限制,因为并不是所有的视图记录都能够唯一的对应到基本表中的一条记录。
视图更新的限制:
- 行列子集视图是可以更新的
- 如果视图定义中使用了DISTINCT、GROUP BY分组或者是聚集函数,那么这样的视图是不能更新的
- 如果视图定义中使用了多表联接或者含有嵌套查询,那么通常情况下这样的视图是不能更新的
视图的优点
- 提供了数据的逻辑独立性
- 简化了用户应用
- 提供了一定的数据安全保护功能
3.6 SQL数据控制语言
数据控制亦称为数据保护,包括数据的安全性控制、完整性控制、并发控制和恢复。
权限与角色
数据库上的权限主要包括两种:用户级的权限和表级的权限。SQL标准支持的是表级权限,包括:表的查询(SELECT)、更新(INSERT、UPDATE、DELETE)和引用(REFERENCE)等。
角色并不对应于某个具体的用户,而是对于一类具有共同特征的用户的总称,这样作的目的是为了便于管理。
CREATE ROLE <角色名> [WITH ADMIN {<当前用户名>|<当前角色名>}];
权限的授予和收回
授予:
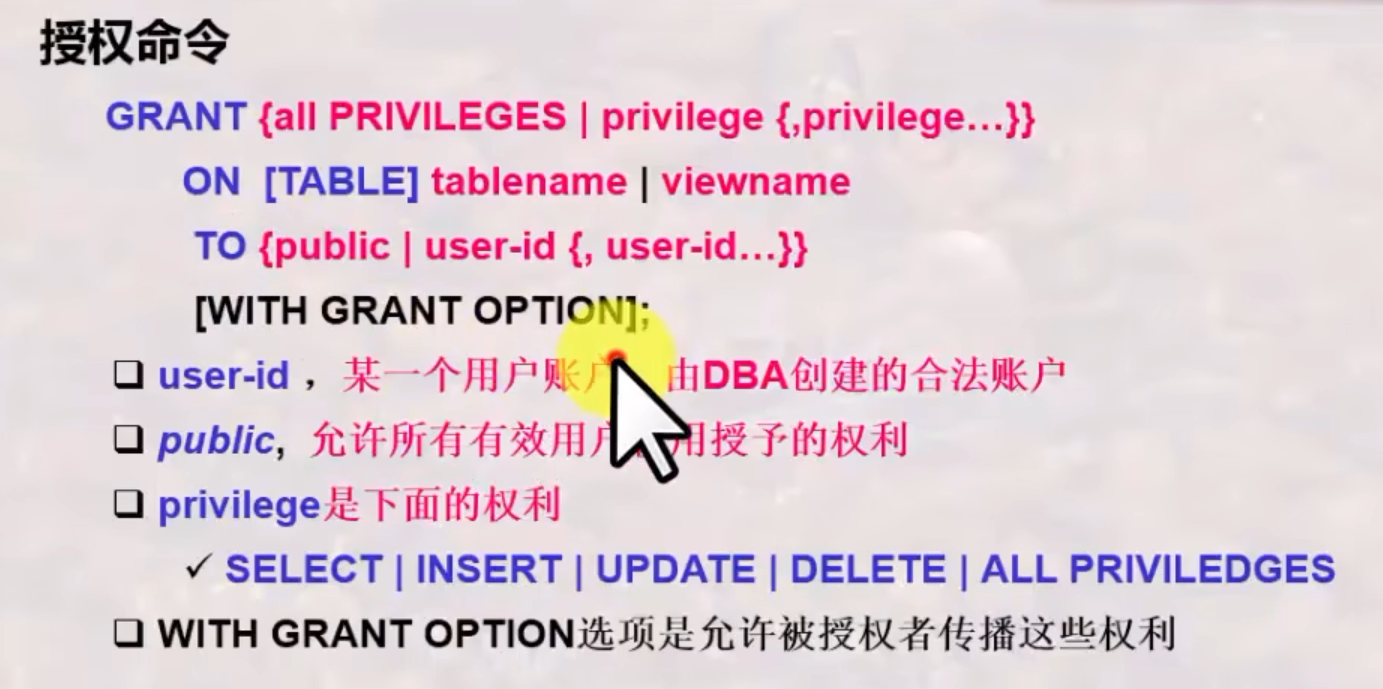
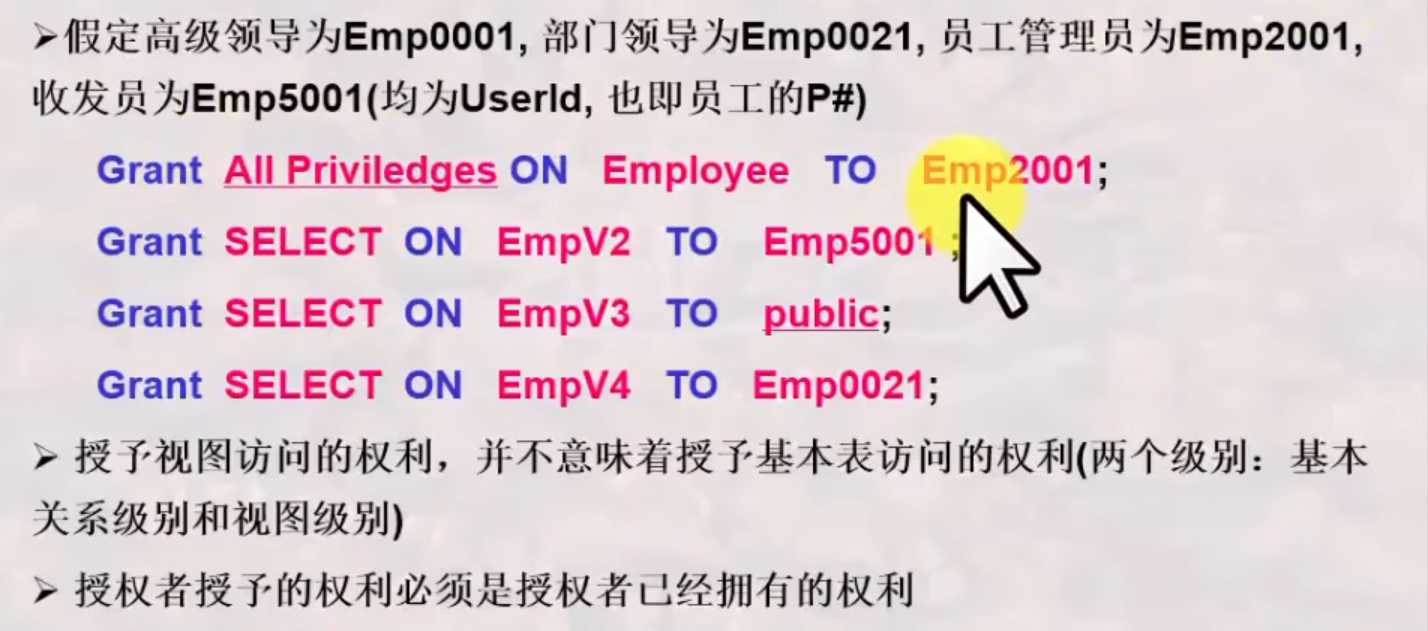
GRANT <权限> ON TABLE <表名> TO <授权ID>,…,<授权ID> [WITH GRANT OPTION];
其中权限包括SELECT、UPDATE、INSERT、DELETE、REFERENCE、ALL PRIVILEGES等。如果使用了WITH GRANT OPTION,则表明该权限是可以转授的。
收回:
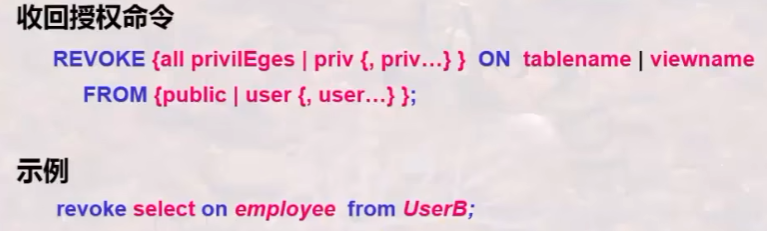
REVOKE <权限> ON TABLE <表名> FROM <授权ID>,…,<授权ID>;
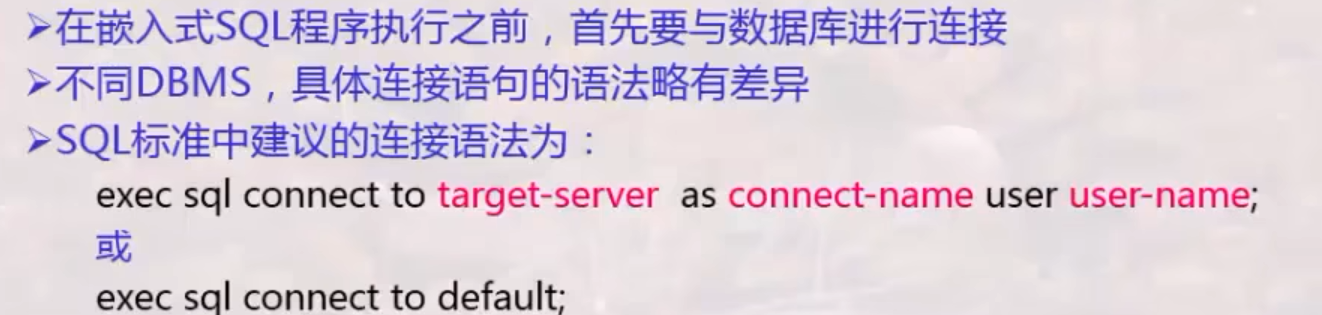
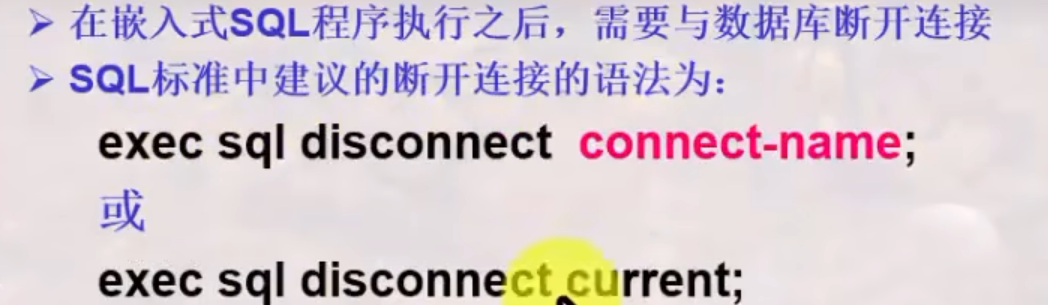
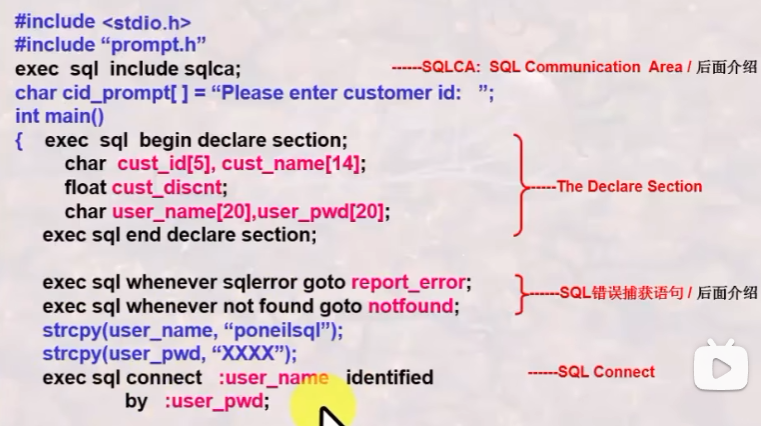
3.7 嵌入式SQL
SQL语言提供了两种使用方式:
- 在终端交互式方式下使用
- 将SQL语言嵌入到某种高级语言如C、C++、Java中使用,嵌入SQL的高级语言称为主语言或宿主语言
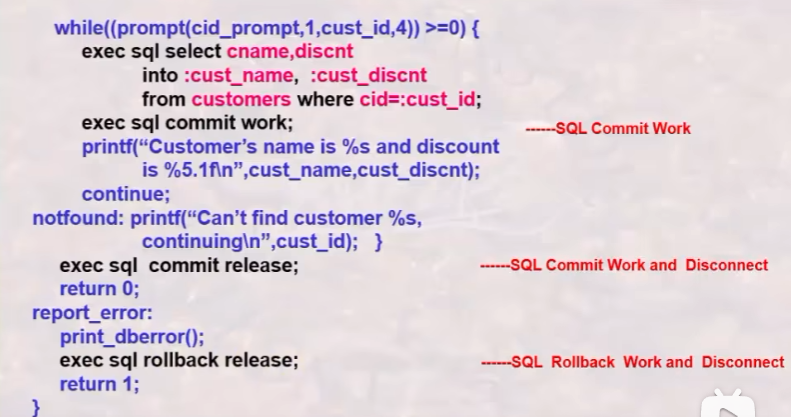
嵌入式SQL与主语言之间的通信
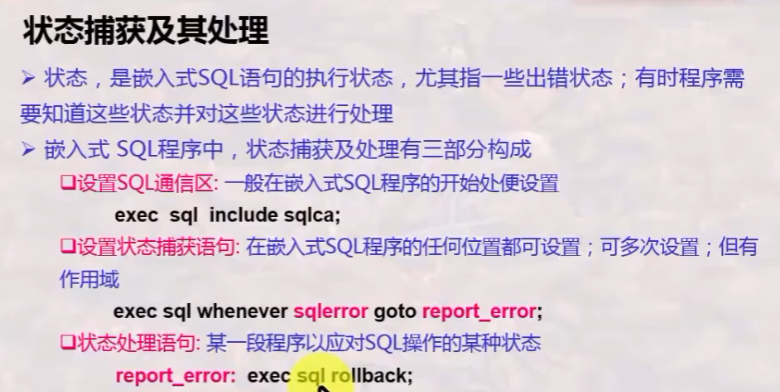
- 向主语言程序传递SQL语句的执行状态信息(通过SQL通信区SQLCA实现)
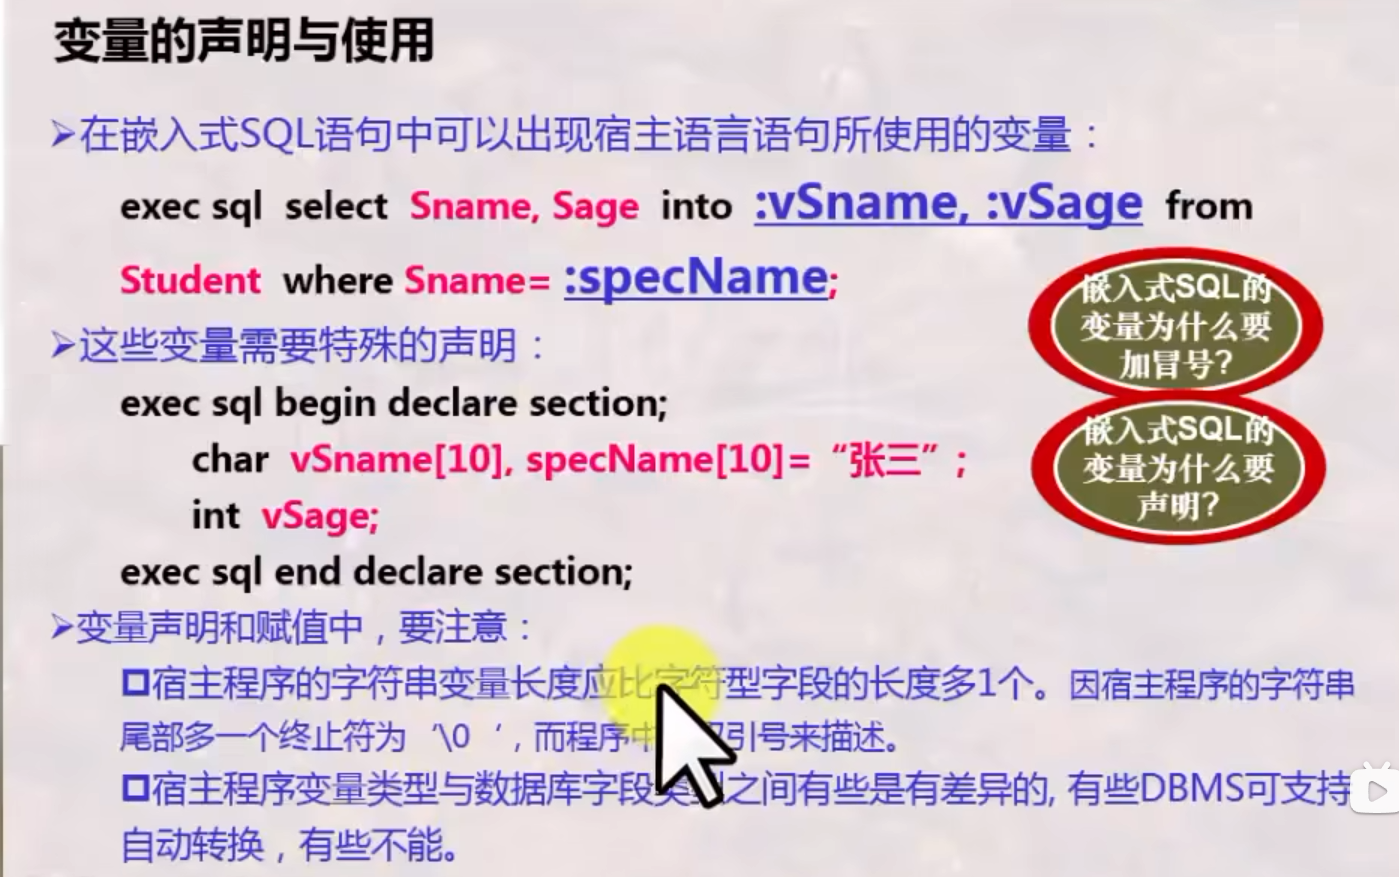
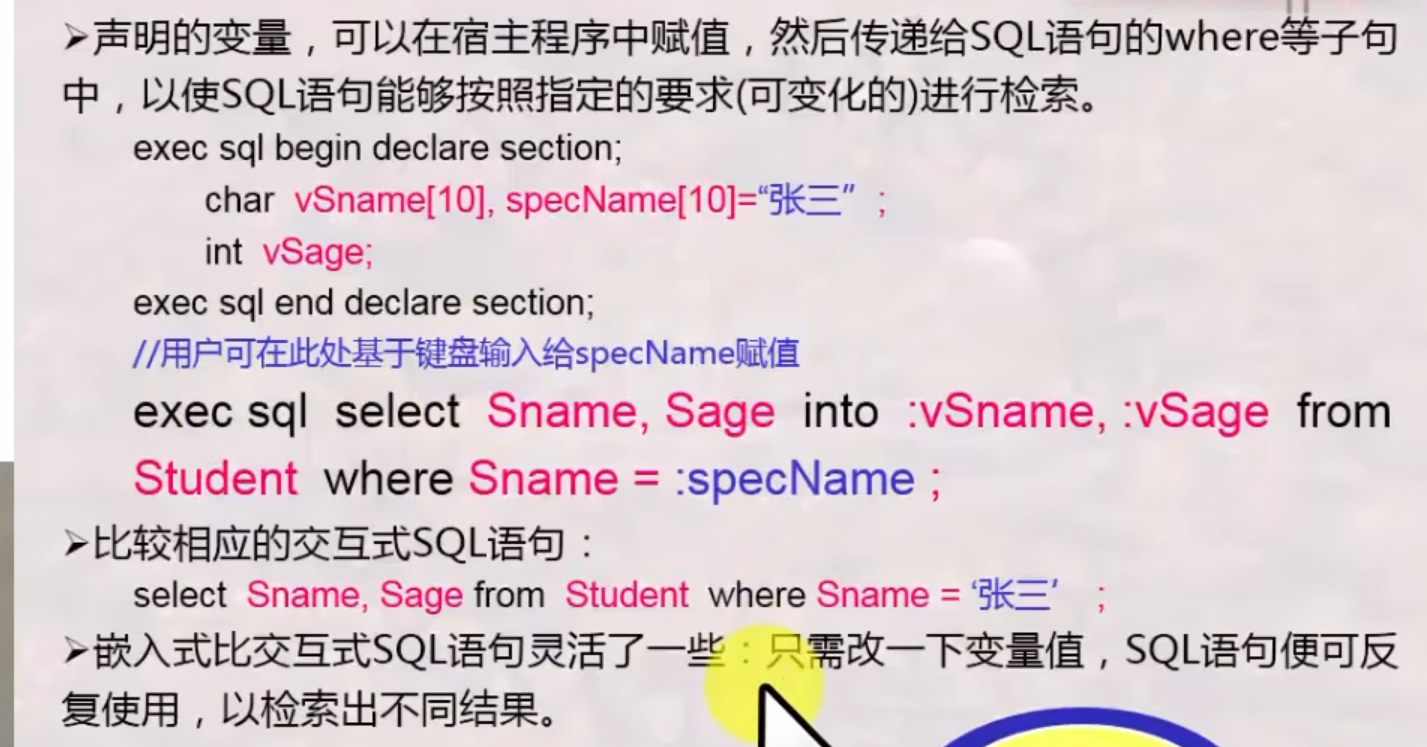
- 主语言程序向SQL语句提供参数(通过主变量实现)
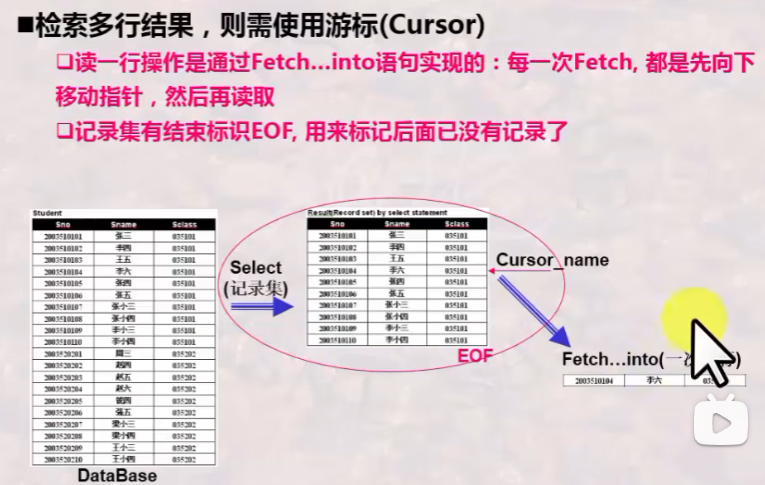
- 将SQL语句查询数据库的结果交主语言程序进一步处理(通过主变量和游标实现)
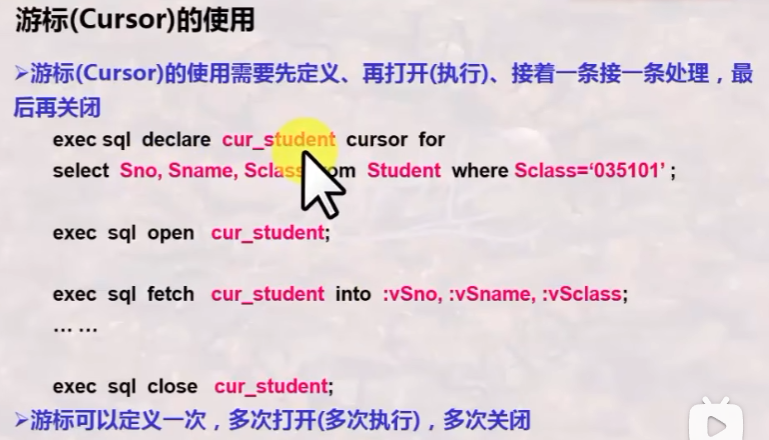
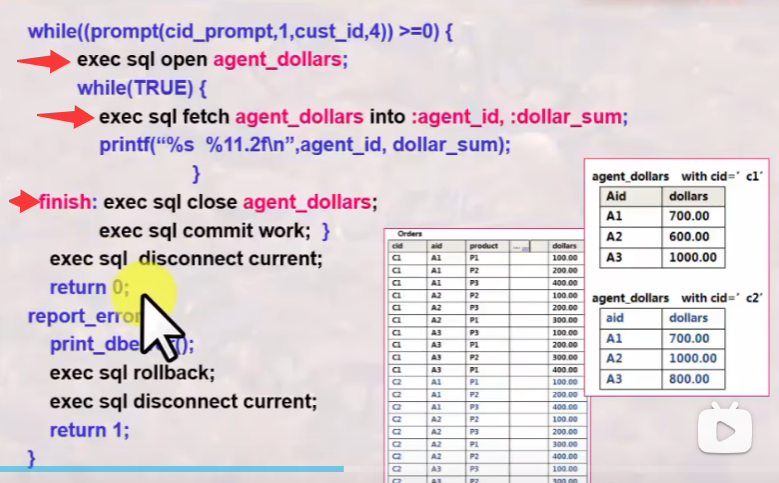
游标
SQL语言是面向集合的,主语言是面向记录的。嵌入式SQL引入了游标的概念,用游标来协调这两种不同的处理方式。游标是系统为用户开设的一个数据缓冲区,存放SQL语句执行后返回的结果集。
使用游标的步骤:
- 说明游标:
EXEC SQL DECLARE <游标名> CURSOR FOR <SELECT语句>;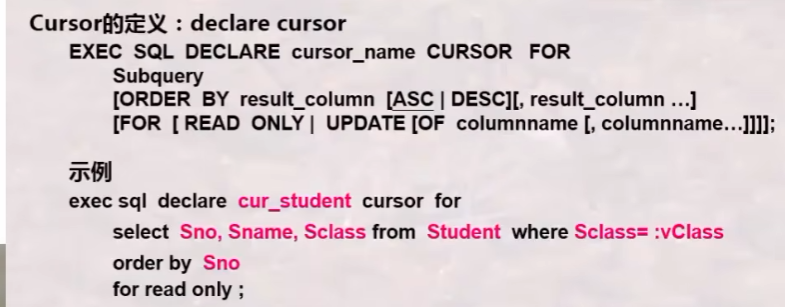
- 打开游标:
EXEC SQL OPEN <游标名>;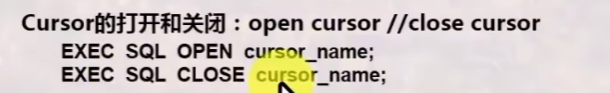
- 推进游标指针并取当前记录:
EXEC SQL FETCH <游标名> INTO <主变量>[,...];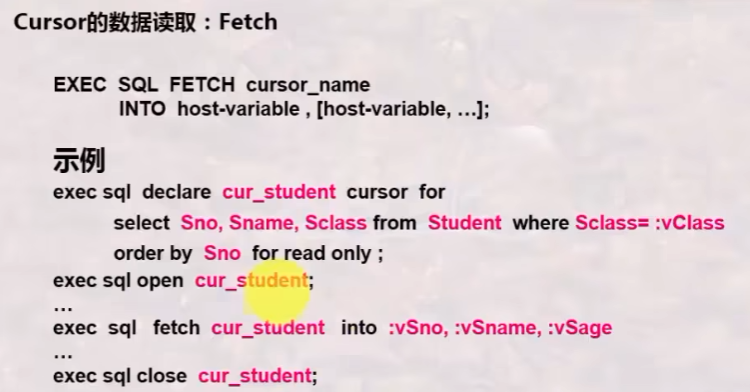
- 关闭游标:
EXEC SQL CLOSE <游标名>;
不需要使用游标的情况:
- 说明性语句
- 数据定义语句
- 数据控制语句
- 查询结果为单记录的SELECT语句(使用INTO子句)
- 非CURRENT形式的UPDATE和DELETE语句
- INSERT语句

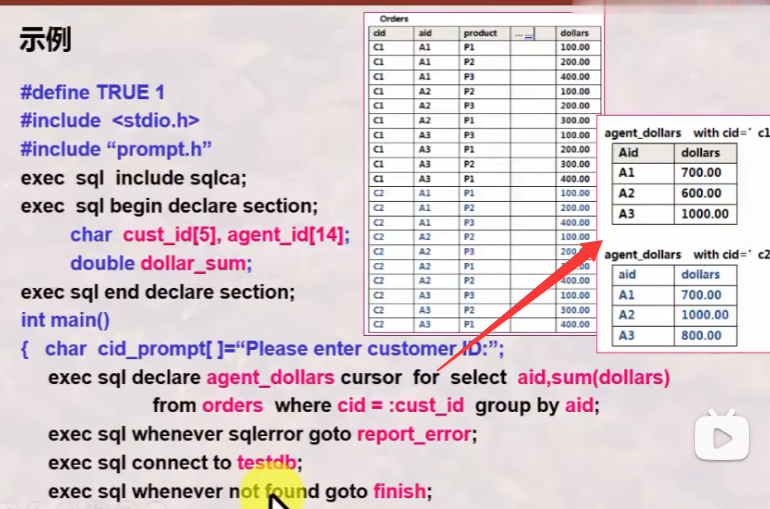
示例
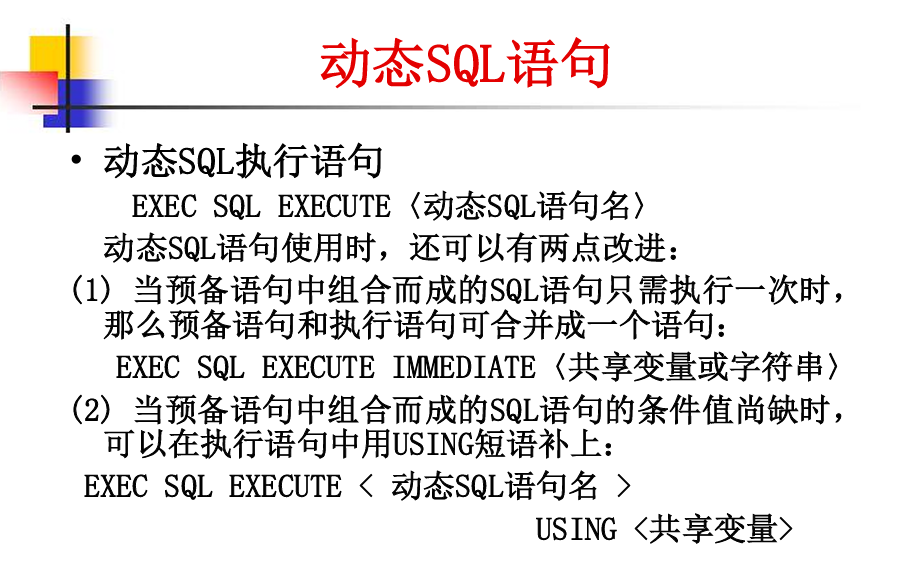
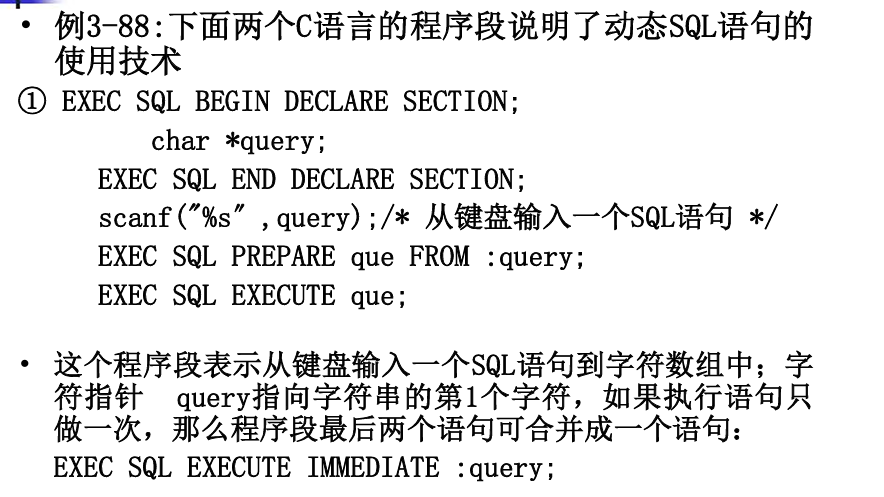
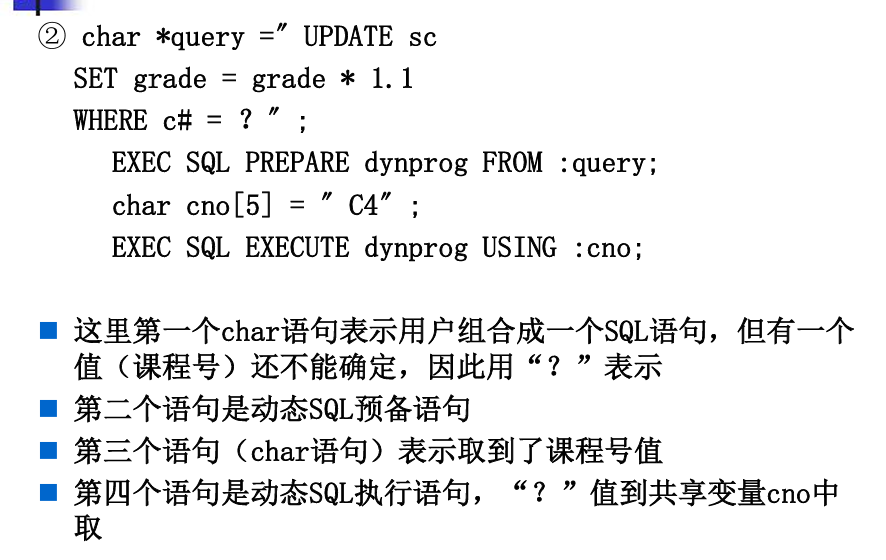
动态SQL
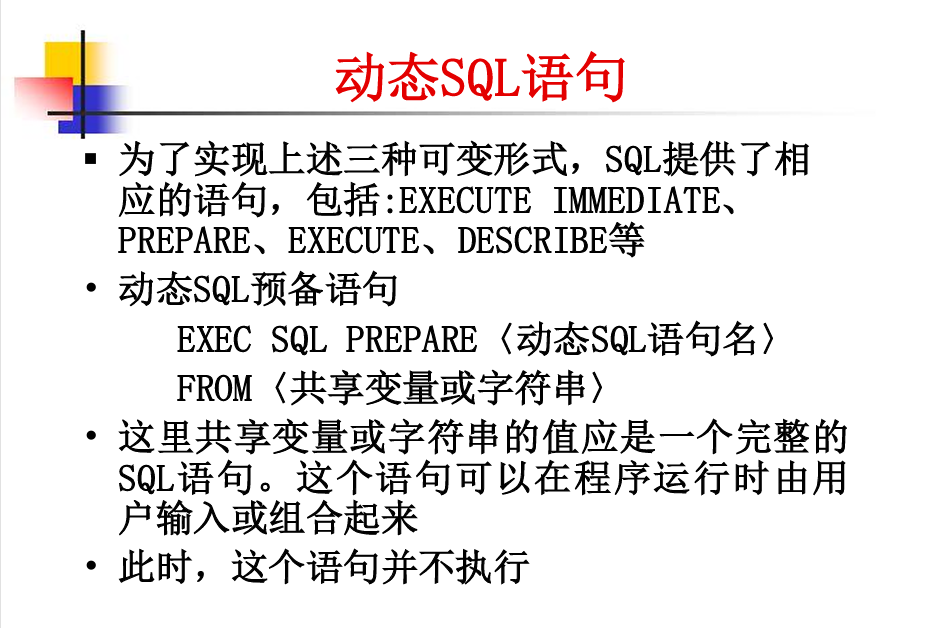
动态SQL方法允许在程序运行过程中临时"组装"SQL语句,主要有三种形式:
- 语句可变
- 条件可变
- 数据库对象、查询条件均可变
关键语句:EXECUTE IMMEDIATE、PREPARE、EXECUTE、DESCRIBE等。
第4章 数据依赖与关系模式规范化
4.1 问题的提出
针对一个具体的应用问题,应该如何构造一个适合于它的关系数据库模式?应该构造几个关系模式?每个关系由哪些属性组成?本章的任务是研究设计一个"好"的(即没有"毛病"的)关系模式的方法。
关系模式SCT(S#,C#,GRADE,Teacher,Dept)存在的问题:
- 数据冗余(Redundancy)
- 更新异常(Update Anomalies)
- 插入异常(Insertion Anomalies)
- 删除异常(Deletion Anomalies)
"好"的模式应使数据冗余应尽可能少,不会发生插入异常、删除异常、更新异常。原因在于存在于模式中的某些数据依赖引起的,解决方法是通过分解关系模式来消除其中不合适的数据依赖。
4.2 数据依赖
数据依赖(Data Dependency)是通过一个关系中各属性值相等与否体现出来的一种数据间的相互制约关系,是现实世界中事物属性间相互联系的抽象,是数据内在的性质,是语义的体现。最重要的是函数依赖(FD) 和多值依赖(MVD)。
关系的内涵和外延
- r是关系模式R上的一个实例,记为
。通常关系模式很少变化,经常发生变化的是关系的实例,因此将关系的模式称为关系的内涵,而将关系的实例r称为关系的外延。 - 关系的内涵是对数据的定义以及数据完整性约束的定义,一般是与时间独立的。
函数依赖(FD)
定义4.1:设R为关系模式,r是R上的任意一个关系实例,
函数依赖是语义范畴的概念,它反映了一种语义完整性约束,只能根据语义来确定一个函数依赖是否成立。函数依赖是指关系R模式的所有关系元组均应满足的约束条件,而不是关系模式中的某个或某些元组满足的约束条件。
定义4.2:如果
定义4.3:如果
定义4.4:如果有
函数依赖的逻辑蕴涵与闭包
定义4.5:设F是在关系模式R上成立的函数依赖的集合,
定义4.6:由函数依赖集合F所逻辑蕴涵的全部函数依赖所构成的集合称之为F的闭包,记作
Armstrong公理(正确且完备):
- A1(自反率):如果
,则 成立 - A2(增广率):如果
成立,且 ,则 成立 - A3(传递率):如果
, 成立,则 成立
由A1~A3可推出: - 合并规则:若
, 成立,则 成立 - 伪传递规则:若
, 成立,则 成立 - 分解规则:若
,且 ,则有
Armstrong公理的正确性是指"使用推理规则从FD集F推出的FD必定在中"。完备性是指" 中的FD都能从F集使用推理规则集导出"。Armstrong公理的正确性和完备性保证了FD推导过程的有效性和可靠性。
属性集合的闭包
定义4.8:属性集X关于
计算
- 令
, - 求
- 判断
吗? - 若相等或
则 就是 ,算法终止 - 若否,则
,返回第2步
函数依赖集的等价与最小覆盖
定义4.8:设F,G是两个函数依赖集合,如果
定义4.9(最小函数依赖集/最小覆盖):若F满足:
- F中所有函数依赖的右部均为单属性
- F中不存在这样的函数依赖
及 ,使得 - F中不存在这样的函数依赖
:使得
则称F为最小函数依赖集或最小覆盖。
求最小依赖集的步骤: - 右部拆成单属性
- 考察左部不是单属性的函数依赖,消除多余属性
- 逐一检查F中各函数依赖
,令 ,若 ,则从F中去掉此函数依赖
F的最小依赖集不一定是唯一的,它和我们对各函数依赖 及 中X各属性的处置顺序有关。
多值依赖(MVD)
定义4.10:设R(U)是属性集U上的一个关系模式。X,Y,Z是U的子集,并且
多值依赖的推导规则(公理):
- A4(互补律):如果
,则 - A5(扩展律):如果
且 ,则 - A6(传递律):如果
且 ,则 - A7:如果
,则 (FD是MVD的特例) - A8:如果
、 且对某一个与Y不相交的W有 ,则
多值依赖的性质: - 对称性:若
,则 ,其中 - 传递性:若
, ,则 - 函数依赖可以看作是多值依赖的特殊情况:若
,则 - 若
, ,则 ; ; ,
函数依赖与多值依赖的区别: - 函数依赖规定某些元组不能出现在关系中(相等产生依赖)
- 多值依赖要求某种形式的其它元组必须在关系中(元组产生依赖)
如果关系中存在非平凡非FD的多值依赖则会导致数据冗余和更新异常等问题,所以要消除异常必须消除多值依赖,方法是建立两个关系,让每个关系只存储一个多值属性的数据。
4.3 关系模式分解
我们可以通过把一个"大的"关系模式分解成多个"小的"关系模式,以解决插入异常、删除异常和更新异常等问题。关系模式的分解,不仅仅是属性集合的分解,也是对关系模式上的函数依赖集,以及关系模式的当前值的分解的具体表现。
无损联接分解
定义4.16:设R是一个关系模式,F是R上的一个FD集,
对于只有2个关系模式的分解,定理4.4:
无损分解的判别方法(表格法/Chase过程):
- 构造一张k行n列的表格,每列对应一个属性Aj,每行对应一个模式Ri
- 反复检查F中每个FD在表格中是否成立,若不成立则修改表格中的值
- 若修改的最后一张表格中有一行是全a,即a1a2…an,那么ρ相对于F是无损分解
保持函数依赖的分解
定义4.18:设
模式分解的两个特性实际上涉及到两个数据库模式的等价问题:数据等价用"无损分解"衡量;依赖等价是指两个数据库模式应有相同的依赖集闭包。
4.4 关系模式的规范化
关系数据库中的关系模式要满足一定的规范化要求,满足不同程度规范化要求的关系模式的类,称为不同的范式(Normal Forms,简记为NF)。基于FD的范式有1NF、2NF、3NF、BCNF等多种。
范式之间的关系(由低到高):1NF → 2NF → 3NF → BCNF → 4NF → 5NF
规范化的过程(由低到高):
1NF ──消去非主属性对键的部分函数依赖──→ 2NF
2NF ──消去非主属性对键的传递函数依赖──→ 3NF
3NF ──消去主属性对键的传递函数依赖──→ BCNF
BCNF ──消去非平凡且非函数依赖的多值依赖──→ 4NF
第一范式(1NF)
定义4.19:如果关系模式R的每个关系r的属性值都是不可分的原子值,则称R是第一范式(1NF)的模式。1NF是关系模式应具备的最起码的条件。
键的相关概念
- 超键:若
,则称K为R的一个超键 - 候选键(CK):超键K的任何真子集都不再是超键,则称K为R的一个候选键
- 主键(PK):从多个候选键中选定一个
- 主属性:包含在任何一个候选键中的属性
- 非主属性:不包含在任何候选键中的属性
求候选键的方法: - C1:不在任何函数依赖中出现的属性
- C2:仅在函数依赖决定子中出现的属性
- C3:仅在函数依赖右部出现的属性
- C4:在函数依赖左部右部均有出现的属性
注意:任何候选键中必然会包括C1、C2中的属性。若或 ,则 即为惟一的候选键;否则逐一将C4中的属性加入 并计算其闭包。
第二范式(2NF)
定义4.23:如果关系模式R中的所有非主属性都完全函数依赖于所有CK,则称R满足2NF,表示为
第三范式(3NF)
定义4.24:如果关系模式R中的非主属性既不部分函数依赖也不传递函数依赖于R上的所有候选键,则称R满足3NF,表示为
推论:当R上每一个FD
(即 是一个平凡的FD) - X是R的超键
- A是主属性
BCNF(Boyce-Codd NF)
定义4.25:若对于R上的任何非平凡函数依赖
第四范式(4NF)
定义4.26:设D是关系模式R上成立的FD和MVD集合。如果D中每个非平凡的MVD
判断范式级别的方法
- 求出给定关系的候选键(可能不止一个)
- 根据键,确定主属性和非主属性
- 判断是否满足第一范式(看属性的值域是否可以分解)
- 判断是否满足第二范式(非主属性对键的部分函数依赖)
- 判断是否满足第三范式(非主属性对键的传递函数依赖)
- 判断是否满足BCNF范式(主属性对键的传递函数依赖)
分解算法
- 3NF分解算法:既无损连接又保持函数依赖。先将FR转换为等价的最小覆盖,按照左部相同原则分组,再添加由任一候选键构成的关系模式以保证无损连接。
- BCNF分解算法:保证无损连接。如果ρ中的每个子关系模式均是BCNF则算法终止,否则将不满足BCNF的子关系模式分解为两个,重复直至所有子模式都是BCNF。
模式设计的三条原则:表达性、分离性和最小冗余性。一般尽可能设计成BCNF模式集,如果设计成BCNF模式集时达不到保持FD的特点,那么只能降低要求,设计成3NF模式集。
第5章 数据库设计
5.1 概述
数据库设计是数据库生命周期中的最重要的阶段,其好坏直接影响整个数据库系统的成败。数据库设计是指在一个特定应用环境下,根据用户的信息需求、处理需求和数据库支撑环境(包括DBMS、OS和硬件),构造最合理的数据库模式,创建数据库及其相关应用系统的过程。
数据库系统的生存期:
- 系统规划
- 数据库设计:需求分析、概念设计、逻辑设计、物理设计
- 系统实现:应用程序编码、调试
- 运行和维护
数据库设计的特点
数据库设计主要有以下两种方法:
- 面向数据的设计方法(data-oriented approach):以信息需求为主,兼顾处理需求;
- 面向过程的设计方法(process-oriented approach):以处理需求为主,兼顾信息需求;
数据相对比较稳定,而处理则相对容易变动,所以为了设计一个相对稳定的数据库,数据库设计主要采用面向数据的设计方法。
数据库设计方法
- 新奥尔良(New Orleans)方法:将数据库设计分为若干阶段和步骤
- 基于E-R模型的数据库设计方法:概念设计阶段广泛采用
- 3NF(第三范式)的设计方法:逻辑阶段可采用的有效方法
数据库设计的基本步骤
- 需求分析阶段:准确了解与分析用户需求(包括数据与处理),最困难、最耗费时间的一步。
- 概念结构设计阶段:整个数据库设计的关键,通过对用户需求进行综合、归纳与抽象,形成一个独立于具体DBMS的概念模型。
- 逻辑结构设计阶段:将概念结构转换为某个DBMS所支持的数据模型,对其进行优化。
- 数据库物理设计阶段:为逻辑数据模型选取一个最适合应用环境的物理结构(包括存储结构和存取方法)。
- 数据库实施阶段:建立数据库、编制与调试应用程序、组织数据入库、进行试运行。
- 数据库运行和维护阶段:在数据库系统运行过程中必须不断地对其进行评价、调整与修改。
需求分析和概念设计独立于任何数据库管理系统,逻辑设计和物理设计与选用的DBMS密切相关。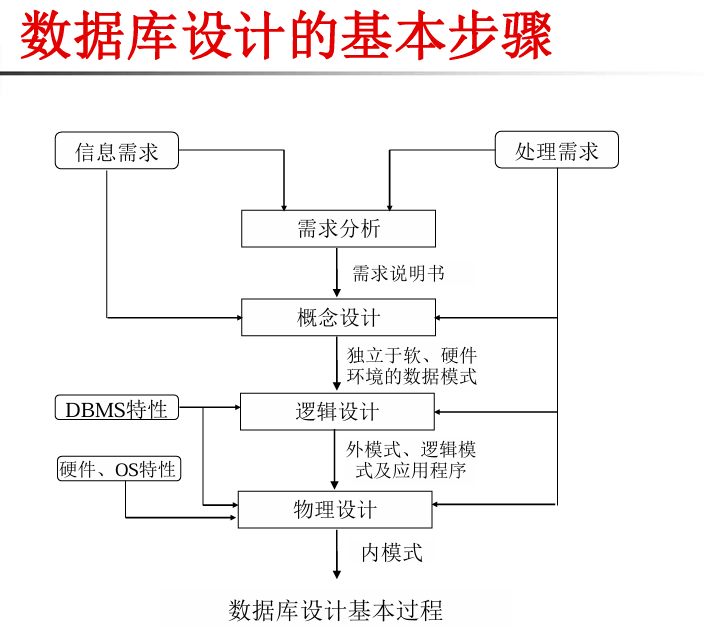
5.2 需求分析
需求分析阶段主要负责收集用户的信息需求及处理需求,并加以分析、整理、统一,最终形成用户需求分析说明书。
需求分析的重点是用户的"数据"和"处理",包括信息要求、处理要求、安全性与完整性要求。
需求分析的步骤:
- 需求信息的收集(了解用户需求)
- 需求信息的分析整理
- 编写需求分析说明
需求分析的结果:
- 系统范围图(确定系统范围)
- 业务流程图(分析用户活动)
- 数据流图(分析用户活动涉及的数据)
- 数据字典(分析系统数据)
5.3 概念设计
将需求分析阶段得到的用户需求抽象为信息结构即概念模型的过程就是数据库的概念设计。概念模型是对现实世界的一种抽象,即对实际的人、物、事和概念进行人为处理,抽取人们关心的共同特性,忽略非本质的细节。
经过概念设计所得到的数据模式应当是与DBMS无关的,且独立于软硬件应用环境。
ER模型的基本元素
- 实体:客观世界中可区别的客观对象或抽象概念
- 联系:实体之间的关联关系
- 属性:实体特征的抽象描述
ER模型的属性设计考虑: - 基本属性与复合属性(可否再分)
- 单值属性和多值属性
- 导出属性、空值
联系的设计
- 联系的元数:一个联系涉及到的实体集个数
- 联系的连通词(基数比约束)(一对一、一对多、多对多):联系涉及到的实体集之间实体对应的方式
- 实体的基数(参与约束):用(min, max)形式表示
扩充的ER模型(EER)
包括:弱实体、普遍化(Generalization)/特殊化(Specialization)、范畴(Category)、聚集(Aggregation)等概念。
概念设计的策略
- 自顶向下:首先建立较高抽象层次的模式,然后再逐步细化、求精
- 自底向上:首先从具体的基本对象开始,建立一个包含有基本抽象的模式,然后再在此基础上进行组合、修改、抽象
- 由内向外:自底向上策略的一个特例
- 混合策略:自顶向下方式和自底向上方式的一种有效结合
视图集成
各局部应用的E-R图设计完成后,需要将其合并形成一个全局的E-R图模式。
解决冲突类型:
- 命名冲突:同名异义和异名同义
- 属性冲突:属性域冲突和属性取值单位冲突
- 类型冲突:同一个概念在不同视图中被抽象成了不同类型的对象
- 约束冲突:语义约束方面的不一致
消除冗余包括数据冗余和联系冗余两种情况。冗余的数据是指可以由其它基本数据导出的数据,冗余的联系是指可以由其它联系导出的联系。
5.4 逻辑设计
逻辑设计的任务是在概念设计的基础上给出与DBMS相关的数据库逻辑模式。例如,将E-R图转换为某种具体的(如关系)数据模型。
ER模型向关系模型的转换原则
- 实体转换为关系模式:关系模式的属性集由实体原有的属性集构成,实体的键是关系模式的键。
- 非原子属性:可以按照纵向展开或横向展开的方式将其转化为原子属性。
- 联系的转换:
- 1:1联系:可与一端合并,或转换为独立的关系模式
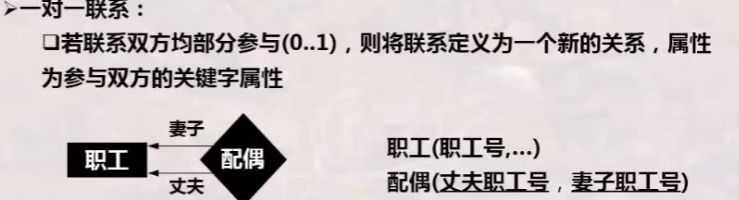
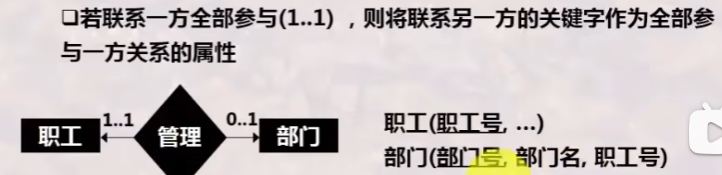
- 1:N联系:可与N端合并,或转换为独立的关系模式
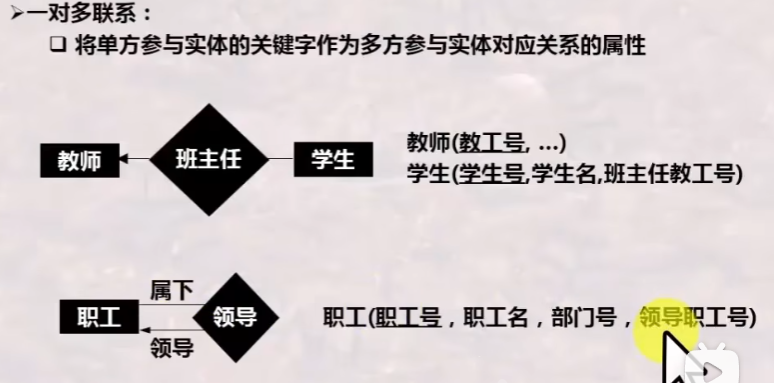
- M:N联系:转换为独立的关系模式,由参与联系的实体的键共同构成键
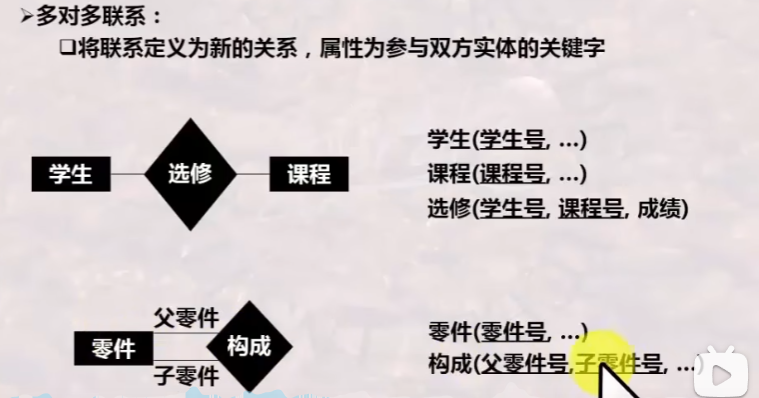
- 三元联系:按照M:N二元联系的情况处理
- 1:1联系:可与一端合并,或转换为独立的关系模式
优化与调整
结构方面的调整:通过关系规范化理论对关系模式进行优化,以减少数据冗余和更新异常问题的出现。性能的调整:通过减少查询时连接运算次数和改变关系大小等方式提高数据处理速度。
规范化过程步骤:
- 确定数据依赖
- 参照最小覆盖算法对每个关系模式内及关系模式间的数据依赖进行极小化处理,消除冗余依赖
- 逐一分析每个关系模式属于第几范式,一般只要达到3NF或BCNF即可
5.5 物理设计
为一个给定的逻辑数据模型选取一个最适合应用环境的物理结构(存储结构与存取方法)的过程,就是数据库的物理设计。
物理设计的步骤:
- 确定数据的存储结构(综合考虑存取时间、存储空间利用率和维护代价)
- 确定数据的存放位置(将表和索引分别放在不同的磁盘上以提高I/O并行性)
- 确定数据的存取方法(索引、聚簇、散列等)
- 确定系统配置
- 对物理结构进行评价
常用的存取方法
- 索引法:为加快按某个属性(组)进行存取的效率,根据该属性(组)建立索引,如B+树。
- 聚簇(Cluster)法:为提高按聚簇键进行查询的效率,将聚簇键上具有相同值的元组存放在连续物理块。一个数据库可以建立多个聚簇,但一个关系只能有一个聚簇。
- HASH法:设计合理的HASH函数,根据关键字值计算得到存储地址。
建立索引的参考: - 主键和外键上应该建立索引
- 经常作为连接条件或查询条件的属性
- 对以读操作为主的关系,可以多建立一些索引
- 不经常使用的属性、属性值很少或分布不均匀的属性、频繁变动或较小的关系不宜建立索引
5.8 数据库实施
数据库实施阶段主要包括:
- 用DDL定义数据库结构
- 组织数据入库
- 编制与调试应用程序
- 数据库试运行
5.9 数据库运行与维护
维护工作主要由DBA完成,包括:
- 数据库的转储和恢复
- 数据库性能的监督、分析和改进
- 数据库的重组(不会改变原设计的数据逻辑结构和物理结构,只是重新安排存储位置)
- 数据库的重构(适当调整数据库的模式和内模式)
第7章 查询处理与查询优化
7.1 引言
查询是数据库系统中最基本、最常见和最复杂的操作。从用户给出的查询请求开始,直到得到查询结果,这一过程称为查询处理。对于一个给定的查询,通常会有许多种可能的执行策略,查询优化就是从众多策略中找出高效执行策略的处理过程。查询处理和优化是DBMS实现的关键技术,对系统性能有很大影响。
查询处理的步骤
- 将查询转换成某种内部表示,通常是语法树
- 根据一定的等价变换规则把语法树转换成标准(优化)形式
- 选择低层的操作算法
- 生成查询计划,对每个执行计划计算代价,从中选择代价最小的一个
查询优化的必要性
查询优化的优点不仅在于用户不必考虑如何最好地表达查询以获得较好的效率,而且在于系统可以比用户程序的"优化"做得更好。优化器可以从数据目录中获取许多统计信息,可以考虑数百种不同的执行计划,而程序员一般只能考虑有限的几种可能性。
查询优化的途径
- 代数优化:对查询语句进行等价变换,只涉及查询语句本身,而不涉及存取路径
- 物理优化:根据系统提供的查询路径,选择合理的存取策略,依赖于存取路径的优化
- 规则优化:根据启发式规则选择执行策略
- 代价估算优化:根据可供选择的执行策略进行代价估算,从中选择代价最小的执行策略
- 语义优化:通过应用数据库的语义信息对查询进行优化
查询的执行代价:
- 集中式数据库:总代价 = I/O代价 + CPU代价
- 多用户环境:总代价 = I/O代价 + CPU代价 + 内存代价
- 网络分布环境:总代价 = I/O代价 + CPU代价 + 网络传输代价
7.2 代数优化
代数优化使用等价变换规则来优化关系代数表达式,使优化后的表达式满足基本原则。代数优化的基本原则是尽量减小查询处理的中间结果大小。在变换查询时,尽量先安排执行投影、选择,后进行连接、笛卡儿积。
常用的等价变换规则
- 选择的串接:
- 选择的交换:
- 投影的串接:
,条件: - 选择与投影的交换:
,条件: - 连接/笛卡儿积的交换律:
, - 选择对连接/笛卡儿积的分配律
- 投影对连接/笛卡儿积的分配律
- 选择对
、 、 的分配律 - 投影对
的分配律
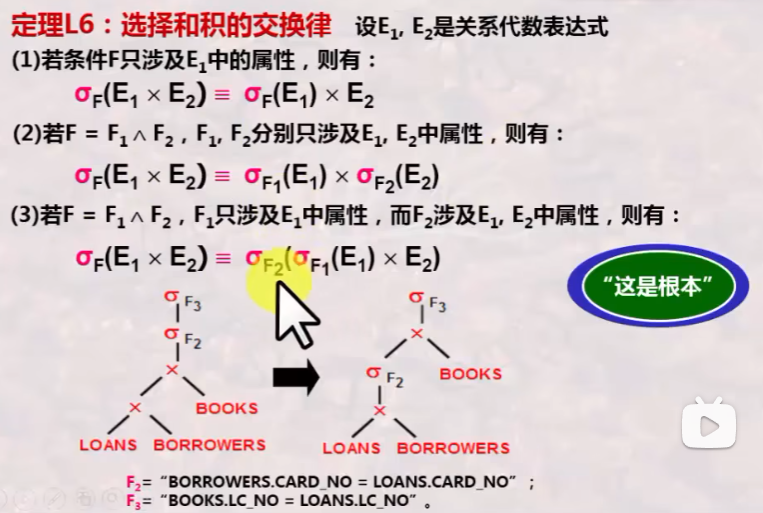
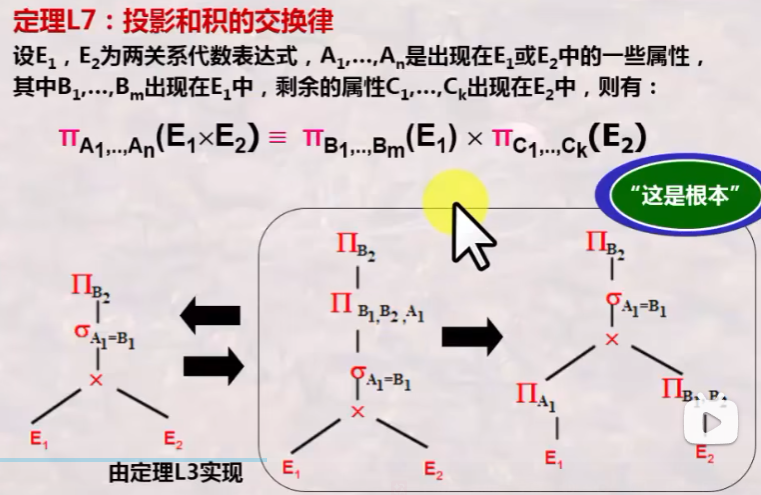
代数优化的策略
- 尽可能早地执行选择操作
- 投影和选择操作同时进行
- 选择和其前执行的笛卡儿积合并成一个连接操作
- 找出表达式中公共子表达式
- 投影和其前后的二元运算结合起来
- 适当的预处理
7.3 物理优化
物理优化又称为依赖于存取路径的优化,而代数优化则属于不依赖于存取路径的优化。
选择操作的启发式规则
- 对于小关系,不必考虑其他存取路径,直接用顺序扫描
- 如果无索引或散列等存取路径可用,或估计中选的元组数在关系中占有较大的比例(例如大于15%),且有关属性上无索引,则用顺序扫描
- 对于主键的等值条件查询,最多只有一个元组可以满足此条件,应优先采用主键的索引或散列
- 对于非主键的等值条件查询,如果比例较小(例如小于15%),可用索引,否则还是使用顺序扫描
- 对于范围条件,一般先通过索引找到范围的边界,再通过索引的顺序集沿相应方向搜索
- 对于用AND连接的合取选择条件,若有相应的多属性索引,则优先采用多属性索引
- 对于用OR连接的析取选择条件,只能按其中各个条件分别选出一个元组集,再求这些元组集的并
- 有些选择操作只要访问索引就可得到结果(如查询索引属性的最大值、最小值、平均值等)
连接操作的实现方法
- 嵌套循环法(nested loop):顺序扫描外关系的每一个元组,然后与内关系的每一个元组进行匹配。应选择占用物理块少的关系作为外关系。
- 利用索引或散列寻找匹配元组法:如果内关系有合适的存取路径,可以考虑使用这些存取路径代替顺序扫描,可有效减少I/O次数。
- 排序归并法(sort-merge):首先按连接属性对关系排序,然后进行归并连接。
- 散列连接法(hash join):首先用散列函数将连接属性散列至文件中,然后对散列到同一个桶中的元组进行匹配。
连接的启发式规则
- 如果两个关系都已按连接属性排序,则优先用排序归并法
- 如果两个关系中有一个关系在连接属性上有索引或散列,则可令另一关系为外关系,利用内关系上的索引或散列寻找其匹配元组
- 如果应用上述两规则的条件都不具备,且两个关系都比较小,可以应用嵌套循环法
- 如果以上规则都不适用,可用散列连接法
第8章 事务管理
8.1 引言
事务是数据库系统中故障恢复和并发控制的基本单位。事务管理主要包括数据库恢复和并发控制。前者在系统发生故障后,将数据库恢复为某个正确或一致状态;后者在多个事务并发访问数据库时,避免访问冲突所引起的数据不一致。
8.2 事务
事务的概念
事务(Transaction)是数据库环境下由一组数据库操作序列组成的逻辑工作单元(Unit of Work/UOW)。这些操作应是一个不可分割的整体,要么全做要么全不做(all or nothing)。事务的执行应保证将数据库从一个一致状态转变成另一个一致状态。
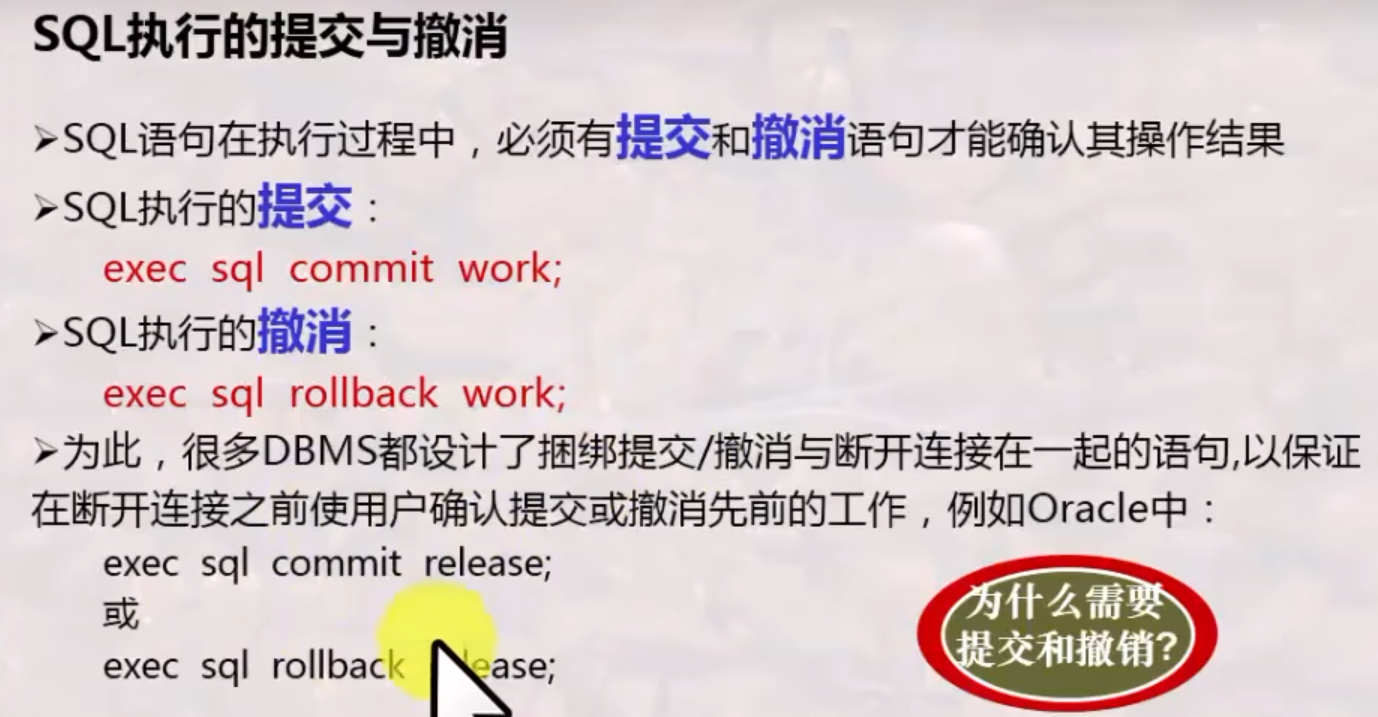
事务通常是以BEGIN TRANSACTION开始,以COMMIT或ROLLBACK结束。
COMMIT表示提交,将事务中所有对数据库的更新写回到磁盘上的物理数据库中去,事务正常结束。ROLLBACK表示回滚,系统将事务中对数据库的所有已完成的操作全部撤消,滚回到事务开始时的状态。
事务的ACID特性
- 原子性(Atomicity):事务中包括的诸操作要么都做,要么都不做。
- 一致性(Consistency):事务执行的结果必须是使数据库从一个一致性状态变到另一个一致性状态。当数据库只包含成功事务提交的结果时,就说数据库处于一致性状态。
- 隔离性(Isolation):一个事务的执行不能被其他事务干扰。即一个事务内部的操作及使用的数据对其他并发事务是隔离的,并发执行的各个事务之间不能互相干扰。
- 持续性(Durability):也称永久性,指一个事务一旦提交,它对数据库中数据的改变就应该是永久性的。接下来的其他操作或故障不应该对其执行结果有任何影响。
保证事务在故障发生时满足ACID性质的措施称为恢复技术;保证多个事务在并行执行时满足ACID性质的措施称为并发控制技术。恢复和并发控制是保证事务正确运行的两项基本技术,被合称为事务管理。
事务的基本操作
:从数据库中将数据对象X读入到执行read操作的事务的一个局部缓冲区中 :从执行write的事务的局部缓冲区把数据对象X写入数据库
事务的状态
活动状态 → 局部提交状态 → 提交状态;活动状态 → 失败状态 → 中止状态。
8.3 故障分类
可以将使得数据库系统无法正常运行的任何事件都称为故障,根据故障的影响范围分为:
- 事务故障:影响单个事务正常运行的任何事件。包括逻辑错误(事务由于内部逻辑上的问题而无法继续正常执行)和系统错误(系统进入非正常状态,中断了事务的执行)。恢复程序需强行回滚(ROLLBACK)该事务,即事务撤消(UNDO)。
- 系统故障:造成系统停止运转的任何事件,使得系统要重新启动。影响所有正在运行的事务,不破坏数据库但主存内容丢失。需要UNDO所有未完成事务并REDO所有已提交事务。通过运行日志回复。
- 介质故障:主要指外存故障,如磁盘损坏、磁头碰撞,瞬时强磁场干扰等。破坏性最大。需要利用其他磁盘上的数据备份或档案数据库进行重构,然后利用事务日志对最近后备副本以后提交的所有事务进行重做(REDO)。
8.4 数据库恢复技术
数据库管理系统(即恢复子系统)必须具有把数据库从错误状态恢复到某一已知的正确状态(亦称为一致状态或完整状态)的功能,这就是数据库的恢复。
故障恢复的基本原理十分简单,可以用一个词来概括:冗余。这就是说,数据库中任何一部分被破坏的或不正确的数据可以根据存储在系统别处的冗余数据来重建。
恢复机制涉及两个关键问题:
- 如何建立冗余数据
- 如何利用这些冗余数据实施数据库恢复
建立冗余数据的方法
数据库备份:DBA定期地将整个数据库复制到磁带或另一个磁盘上保存起来的过程。这些备用的数据文本称为后备副本或后援副本。备份可分为:
- 脱机(静态)备份和联机(动态)备份
- 全备份、部分备份和增量备份
日志文件:用来记录事务对数据库的更新操作的文件。
日志记录的内容主要包括: - 事务标识TID
- 操作的类型(开始、提交、终止、插入、删除或修改)
- 操作对象
- 更新前数据的旧值(对插入操作而言此项为空值)
- 更新后数据的新值(对删除操作而言此项为空值)
登记日志文件的原则:
- 登记的次序严格按并发事务执行的时间次序
- 必须先写日志文件,后写数据库("提前写日志"原则)
恢复策略
- 事务故障的恢复(UNDO):反向扫描日志文件,对该事务的更新操作执行逆操作,即将日志记录中"更新前的值"写入数据库,直至读到事务的开始标记。
- 系统故障的恢复(UNDO + REDO):
- 正向扫描日志文件,找出已提交事务(REDO队列)和未完成事务(UNDO队列)
- 对UNDO事务:反向扫描,执行逆操作
- 对REDO事务:正向扫描,重新执行日志文件登记的操作
- 介质故障的恢复:重装数据库后备副本,然后利用日志文件重做(REDO)已完成的事务。
使用日志的恢复技术
- 即时更新技术:允许事务直接更新数据库。需要UNDO(T)和REDO(T)两个操作。
- 推迟更新技术:把所有数据库更新操作推迟到该事务提交时执行。只需要REDO(T)操作。
检查点技术
在日志文件中增加检查点记录(checkpoint),动态维护日志文件。周期性执行:将日志缓冲写入磁盘→将数据缓冲写入数据库→写入检查点记录→记录检查点地址。使用检查点方法可以改善恢复效率,当事务在一个检查点之前提交,其修改一定都已写入数据库,不必执行REDO操作。
8.5 数据库并发控制
数据库是一种共享资源,可以供多个用户使用。当多个用户并发地存取数据库时就会产生多个事务同时存取同一数据的情况。若对并发操作不加控制就可能会存取和存储不正确的数据,破坏数据库的一致性。所以数据库管理系统必须提供并发控制机制。
并发执行方式
- 串行访问(serial access):一个事务完全结束后,另一个事务才开始
- 并发访问(concurrent access):事务在时间上重叠执行
- 交叉并发(interleaved concurrency):单CPU系统中各事务交叉使用CPU
- 同时并发(simultaneous concurrency):多CPU系统中多个事务同时占用CPU
事务并发执行可能引起的问题
- 丢失修改(lost update):两个事务T1和T2读入同一数据并修改,T2提交的结果破坏了T1提交的结果,导致T1的修改被丢失。
- 读"脏"数据(dirty read):事务T1修改某一数据并将其写回磁盘,事务T2读取同一数据后,T1由于某种原因被撤消,T2读到的数据就与数据库中的数据不一致。
- 不可重复读(non-repeatable read):事务T1读取数据后,事务T2执行更新操作,使T1无法再现前一次读取结果。
产生上述三类数据不一致性的主要原因是并发操作破坏了事务的隔离性。
可串行化
多个事务的并发执行是正确的,当且仅当其结果与按某一次序串行地执行它们时的结果相同。我们称这种调度策略为可串行化(Serializable)的调度。可串行性(Serializability)是并发事务调度正确性的准则。
冲突操作:属于不同事务、针对同一个数据单元、其中至少有一个写(Write)操作。冲突操作包括读-写冲突和写-写冲突两种。
前趋图:一个有向图G=(V,E),V是参与调度事务的集合,边通过分析事务之间的冲突操作获得。如果前趋图中存在回路,则调度不可能冲突等价于任何串行调度;如果前趋图中不存在回路,则可以用拓扑排序得到等价的串行调度。
8.6 基于锁的并发控制
加锁是实现并发控制的重要的技术。所谓加锁就是事务T在对某个数据对象操作之前,先向系统发出请求,对其加锁。
锁的类型
- 排它锁(X锁/写锁):若事务T对数据对象A加上X锁,则只允许T读取和修改A,其它任何事务都不能再对A加任何类型的锁,直到T释放A上的锁。
- 共享锁(S锁/读锁):若事务T对数据对象A加上S锁,则事务T可以读A但不能修改A,其它事务只能再对A加S锁,而不能加X锁,直到T释放A上的S锁。
- U锁:事务在进行更新时,首先申请对它的U锁,数据对象加了U锁后,仍允许其他事务对其加S锁。待最后需要写入时,事务再申请将U锁升级为X锁。
锁的相容矩阵:
| S | U | X | |
|---|---|---|---|
| S | Y | Y | N |
| U | N | N | N |
| X | N | N | N |
三级加锁协议
- 1级加锁协议:事务T在修改数据R之前必须先对其加X锁,直到事务结束(EOT)才释放。可防止丢失修改,但不能保证可重复读及不读"脏"数据。
- 2级加锁协议:1级加锁协议 + 事务T在读取数据A之前必须先对其加S锁,读完后即可释放S锁。除防止丢失修改外,还可防止读"脏"数据。
- 3级加锁协议:2级加锁协议 + 事务T在读取数据A之前必须先对其加S锁,直到事务结束才释放。除防止丢失修改和不读'脏'数据外,还进一步防止不可重复读。
两段锁协议(2PL)
事务分为两个阶段:
- 扩展阶段:事务可以申请获得任何数据项上的任何类型的锁,但是不能释放任何锁
- 收缩阶段:事务可以释放任何数据项上的任何类型的锁,但是不能再申请任何锁
可以证明,若所有并发执行的事务均遵守两段锁协议,则对这些事务的任何并发调度都是可串行化的。
活锁与死锁
活锁:事务T2等待锁,但系统不断将锁授予后来请求的事务。避免活锁的简单方法是采用"先来先服务"的策略。
死锁:事务间出现循环等待。处理方法分为预防和检测两种。
死锁的预防方法:
- 一次封锁法:要求每个事务必须一次将所有要使用的数据全部加锁
- 顺序封锁法:预先对数据对象规定一个封锁顺序,所有事务都按这个顺序实行封锁
- 等待-死亡(wait-die)策略:年老的事务等待年轻的事务
- 击伤-等待(wound-wait)策略:年轻的事务等待年老的事务
死锁的检测与解除: - 超时法:等待时间超过规定时限即认为发生死锁
- 等待图法:并发控制子系统周期性地检测事务等待图,如发现回路则表示系统中出现了死锁
- 解除死锁:选择一个处理死锁代价最小的事务将其撤消,释放此事务持有的所有的锁
多粒度封锁
多粒度封锁协议允许多粒度树中的每个结点被独立地加锁。引入意向锁(intention lock):
- IS锁(意向共享锁):表示其后裔结点拟加S锁
- IX锁(意向排它锁):表示其后裔结点拟加X锁
- SIX锁(共享意向排它锁):SIX = S + IX
申请封锁时应该按自上而下的次序进行;释放封锁时则应该按自下而上的次序进行。
8.7 其他并发控制技术
- 基于时间标记的并发控制:事务的时间标记决定事务的执行次序。不使用锁,所以不会有死锁发生,但不保证没有活锁。
- 乐观并发控制:事务执行时不做任何检查,直到事务执行结束时,才检查某个事务的修改操作是否违反了可串行性。一般划分为三个阶段:读阶段、检验阶段、写阶段。
第9章 数据库安全性和完整性
9.1 引言
数据库中发生数据错误,归纳起来主要有四个方面的原因:
- 系统发生软、硬件故障,数据遭到破坏
- 事务并发执行引起数据的不一致性
- 数据库的更新操作有误
- 自然的或人为的破坏
针对这四种情况,DBMS必须提供四项数据控制功能:数据库恢复、并发控制、保持完整性、保证安全性。
9.2 数据库完整性
数据库的完整性是指数据的正确性、有效性和相容性。为维护数据库的完整性,DBMS必须提供一种机制来检查数据库中的数据,看其是否满足语义规定的条件。
完整性约束条件
完整性检查是围绕完整性约束条件进行的,因此完整性约束条件是完整性控制机制的核心。
我们将加在数据库之上的语义约束条件称为数据库完整性约束条件,它们作为模式的一部分存入数据库中。
完整性约束条件作用的对象可以是关系、元组、列三种。其状态可以是静态的,也可以是动态的。
六类完整性约束条件:
- 静态列级约束:对一个列的取值域的说明,包括数据类型的约束、数据格式的约束、取值范围或取值集合的约束、空值的约束等。
- 静态元组约束:规定元组的各个列之间的约束关系。
- 静态关系约束:
- 实体完整性约束
- 参照完整性约束(实体完整性约束和参照完整性约束是关系模型的两个极其重要的约束,称为关系的两个不变性)
- 函数依赖约束
- 统计约束
- 动态列级约束:修改列定义或列值时应满足的约束条件。
- 动态元组约束:修改元组的值时元组中各个字段间需要满足某种约束条件。
- 动态关系约束:加在关系变化前后状态上的限制条件。
完整性控制
DBMS的完整性控制机制应具有三个方面的功能:
- 定义功能:提供定义完整性约束条件的机制
- 检查功能:检查用户发出的操作请求是否违背了完整性约束条件
- 如果发现用户的操作请求使数据违背了完整性约束条件,则采取一定的动作来保证数据的完整性
检查时机:立即执行约束(语句执行完后立即检查)和延迟执行约束(延迟到整个事务执行结束后再检查)。
参照完整性的几个问题
- 外键能否接受空值问题
- 在被引用关系中删除元组的问题:级联删除(CASCADE)、受限删除(RESTRICT)、置空值删除(SET NULL)
- 在引用关系中插入元组时的问题:受限插入、递归插入
- 修改关系中主键的问题
完整性约束的说明方法
- CHECK子句:在基表定义中加入CHECK子句,说明各列的值应满足的约束条件
- 断言(ASSERTION):每个断言就是一个谓词,指定了数据库状态必须满足的逻辑条件
- 存储过程:将常用的访问数据库的程序,作为一个过程进行编译,然后存储在数据库中
- 触发器(Trigger):一条在对数据库执行更新操作时系统自动执行的语句,又称主动规则或ECA(事件-条件-动作)规则
9.3 数据库系统安全性
用户标识和鉴别
用户标识和鉴别是系统提供的最外层安全保护措施。其方法是由系统提供一定的方式让用户标识自己的名字或身份。每次用户要求进入系统时,由系统进行核对,通过鉴定后才提供机器使用权。
存取控制
数据库安全性所关心的主要是DBMS的存取控制机制。数据库安全最重要的一点就是确保只授权给有资格的用户访问数据库的权限,同时保证所有未被授权的人员无法接近数据。
存取控制机制主要包括两部分:
- 定义用户权限,并将用户权限登记到数据目录中
- 合法权限检查
用户权限定义和合法权检查机制一起组成了DBMS的安全子系统。
自主存取控制(DAC)
大型数据库管理系统几乎都支持自主存取控制。目前的SQL标准也对自主存取控制提供支持,主要通过SQL的GRANT语句和REVOKE语句来实现。用户权限是由两个要素组成的:数据对象和操作类型。
在SQL中,有两种授权的方式:
- 在数据库一级,由DBA负责授予和收回用户需要得到的必要特权
- 把自身拥有的权限转授给其他用户的授权
自主存取控制能够通过授权机制有效地控制其他用户对敏感数据的存取。但是由于用户对数据的存取权限是"自主"的,用户可自由地决定将数据的存取权限授予何人,在这种授权机制下仍可能存在数据的"无意泄露"。
强制存取控制(MAC)
强制存取控制不是用户能直接感知或进行控制的。适用于那些对数据有严格而固定密级分类的部门,例如军事部门或政府部门。
在强制存取控制中,DBMS所管理的全部实体被分为主体和客体两大类。对于主体和客体,DBMS为它们每个实例(值)指派一个敏感度标记(Label)。敏感度标记被分成若干级别,例如绝密(Top Secret)、机密(Secret)、可信(Confidential)、公开(Public)等。
强制存取控制规则:
- 仅当主体的许可证级别大于或等于客体的密级时,该主体才能读取相应的客体
- 仅当主体的许可证级别等于客体的密级时,该主体才能写相应的客体
在实现MAC时要首先实现DAC,即DAC与MAC共同构成DBMS的安全机制。
视图机制
通过视图机制把要保密的数据对无权存取的用户隐藏起来,从而自动地对数据提供一定程度的安全保护。视图机制间接地实现了支持存取谓词的用户权限定义。
审计
审计功能把用户对数据库的所有操作自动记录下来放入审计日志(Audit Log)中。DBA可以利用审计跟踪的信息,重现导致数据库现有状况的一系列事件,找出非法存取数据的人、时间和内容等。审计功能一般主要用于安全性要求较高的部门。
数据加密
对于高度敏感性数据,还可以采用数据加密技术。数据加密是防止数据库中数据在存储和传输中失密的有效手段。加密的基本思想是根据一定的算法将原始数据(明文,Plain text)变换为不可直接识别的格式(密文,Cipher text)。
加密方法主要有两种:
- 替换方法:使用密钥将明文中的每一个字符转换为密文中的一个字符
- 置换方法:仅将明文的字符按不同的顺序重新排列
将这两种方法结合起来就能提供相当高的安全程度。